
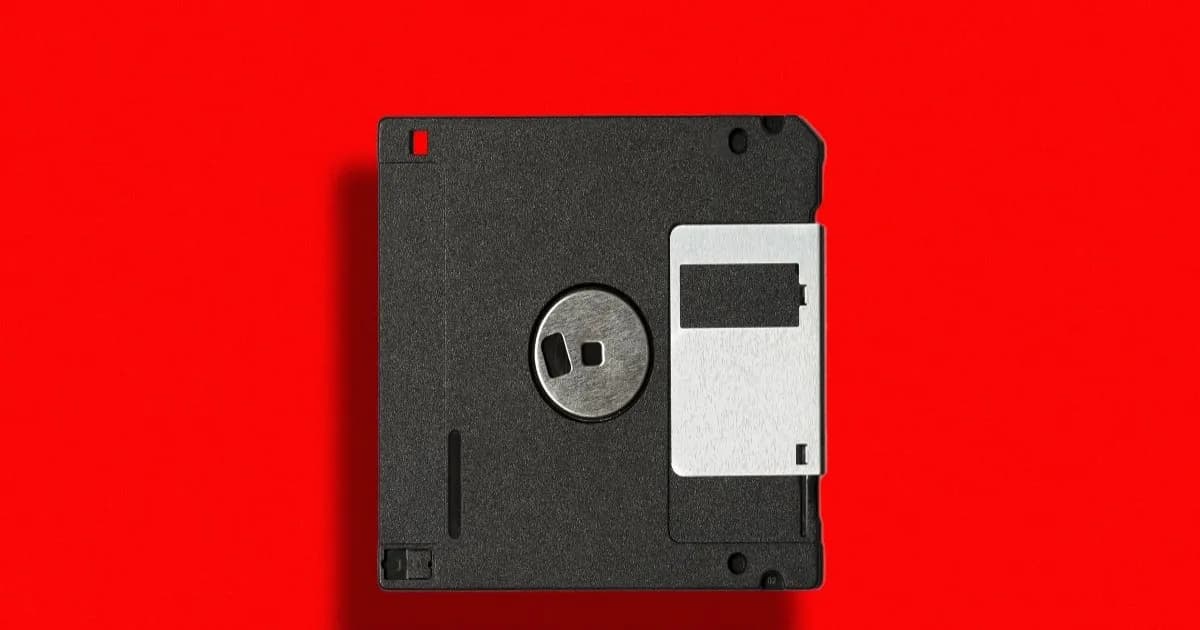
Telset.id – Sebuah model bahasa besar alias large language model (LLM) kini bisa berjalan di komputer yang masih memakai floppy disk. Model transformer sederhana berukuran hanya 380 KB itu ditulis dengan Turbo C 2.0 dan dijalankan di MS-DOS, sistem operasi Microsoft yang menjadi andalan komputer pribadi sepanjang 1980-an hingga awal 90-an. Proyek ini menjadi kontras tajam di tengah tren model AI berparameter triliunan yang menuntut daya komputasi besar.
Temuan ini pertama kali dilaporkan Hackaday dan dikutip Futurism. Ukuran 380 KB membuat model tersebut muat dalam satu floppy disk, media penyimpanan yang kapasitasnya jauh di bawah standar saat ini. Model ini juga hanya membutuhkan memori 540 KB untuk berjalan, kebutuhan yang masuk akal bagi sistem operasi DOS.
Di balik ukurannya yang mungil, model AI ini tetap merupakan transformer, arsitektur yang sama dengan model-model besar masa kini. Bedanya, ia dilatih hanya dengan 3.500 fakta. Jumlah parameter yang dikandungnya sebanyak 367.000, terdiri dari 380 KB bobot 8-bit yang menjadi inti arsitektur AI tersebut. Angka itu sangat kecil dibandingkan model “ringan” sekalipun yang biasanya sudah menyentuh miliaran parameter.
Menariknya, model mungil ini lahir dari bantuan model AI yang lebih besar. Sang pembuat mengaku memakai Anthropic Fable 5.2 untuk menulis model dan Opus 5.5 untuk melatihnya. Dengan kata lain, ada model AI kecil yang dibuat oleh model AI yang lebih besar.
Pendingin Chip AI pun menjadi isu tersendiri di industri, karena model berukuran raksasa menuntut konsumsi daya besar. Di sisi lain, pendekatan seperti model 380 KB ini menunjukkan bahwa arsitektur transformer bisa dipadatkan hingga level ekstrem.

Kemampuan Terbatas dan Jawaban yang Sering Salah
Jangan berharap performa setara Claude. Model ini memiliki kemampuan yang tipis dan sering mengarang jawaban karena memang tidak “tahu” banyak tentang dunia. Antarmukanya pun bernuansa retro, sesuai dengan sistem operasi yang digunakannya.
Sebuah tangkapan layar memperlihatkan contoh kualitas respons AI tersebut. Model ini benar saat menjawab bahwa paus adalah mamalia, bukan ikan, dan bahwa Alexander Graham Bell adalah penemu telepon. Namun ia menjawab bahwa 17 kali 23 adalah 96, sebuah hasil yang keliru.
Yang lebih ganjil, saat ditanya “siapa raja Prancis”, model itu menjawab, “It was Antarce Newton,” dengan tingkat keyakinan 100 persen. Tidak jelas apakah pernah ada orang bernama Antarce Newton dalam sejarah manusia, tetapi model mungil ini menyatakannya dengan percaya diri.
Perilaku tersebut sejalan dengan keterbatasan pelatihannya. Dengan hanya 3.500 fakta, model tidak memiliki pengetahuan dunia yang memadai, sehingga jawaban yang mengarang menjadi konsekuensi yang wajar. Meski demikian, proyek ini tetap menunjukkan bahwa model bergaya LLM dapat dijalankan pada perangkat keras yang sangat tua.
Konteks industri AI saat ini bergerak ke arah sebaliknya. Model berparameter triliunan disebut berkontribusi pada pembengkakan konsumsi energi dan tagihan listrik, sekaligus menghasilkan respons yang sangat mirip manusia. Di tengah kondisi itu, model 380 KB tampil sebagai eksperimen kecil yang menyegarkan.
Baca Juga:
Eksperimen Kecil di Tengah Perlombaan Model Raksasa
Proyek ini bukan tentang menyaingi model komersial, melainkan tentang batas minimum. Pertanyaan yang diajukan sederhana: pada ukuran berapa sebuah large language model berhenti disebut “large”? Model 380 KB ini memberi jawaban yang ekstrem, yakni cukup kecil untuk muat di floppy disk dan berjalan di komputer yang masih memakai media itu.
Dari sisi teknis, kombinasi Turbo C 2.0, MS-DOS, bobot 8-bit, dan kebutuhan memori 540 KB menunjukkan pendekatan yang sangat hemat sumber daya. Tidak ada indikasi model ini ditujukan untuk penggunaan produktif, dan memang kemampuannya tidak dirancang untuk itu.
Sebagai perbandingan, industri chip dan infrastruktur AI justru tengah menghadapi tekanan efisiensi. Langkah seperti produksi 3D DRAM dan pengembangan node tanpa EUV menjadi bagian dari upaya industri menekan biaya dan konsumsi daya. Eksperimen model 380 KB berada di kutub berbeda, tetapi menyoroti persoalan yang sama: seberapa efisien sebuah model AI bisa dibuat.
Bagi publik, proyek ini lebih merupakan demonstrasi teknis ketimbang produk yang bisa dipakai sehari-hari. Tidak ada informasi mengenai ketersediaan, lisensi komersial, atau rencana pengembangan lanjutan. Yang tersedia hanyalah halaman proyek di GitHub yang mendokumentasikan cara model tersebut dibuat dan dijalankan.
Namun, eksperimen ini memperlihatkan bahwa arsitektur transformer tidak selalu identik dengan kebutuhan komputasi besar. Dalam skala sangat kecil, model tetap bisa menghasilkan jawaban benar untuk pertanyaan sederhana seperti mamalia dan penemu telepon, meski akurasinya runtuh pada aritmetika dan pertanyaan faktual yang lebih rumit.
Kepada siapa informasi ini relevan? Terutama bagi penggemar tren industri AI yang ingin melihat sisi lain dari perlombaan model raksasa. Proyek 380 KB ini bukan tolok ukur performa, melainkan pengingat bahwa “large” dalam large language model adalah soal skala relatif, bukan syarat mutlak untuk bisa berjalan.
- Model AI 380 KB berjalan di MS-DOS dengan Turbo C 2.0 dan muat di satu floppy disk.
- Memiliki 367.000 parameter dan 380 KB bobot 8-bit, hanya butuh 540 KB memori.
- Dilatih dengan 3.500 fakta, sering mengarang jawaban dan salah hitung (17 x 23 dijawab 96).
- Dibuat memakai Anthropic Fable 5.2 dan dilatih dengan Opus 5.5.


Komentar
Belum ada komentar.