Telset.id – tufazip, metode kompresi buatan Tufa Labs, berhasil memampatkan 1GB informasi dari Wikipedia menjadi hanya 105,39MB secara lossless, tanpa bantuan model buatan tangan. Riset yang dibangun peneliti Tommy He ini menjadikannya entri terkecil di Large Text Compression Benchmark dari seluruh peserta yang memakai neural network sebagai satu-satunya predictor. Hasil ini menandai perubahan pendekatan: kompresi tidak lagi bergantung pada model rancangan manusia, melainkan pada kemampuan prediksi sebuah Transformer.
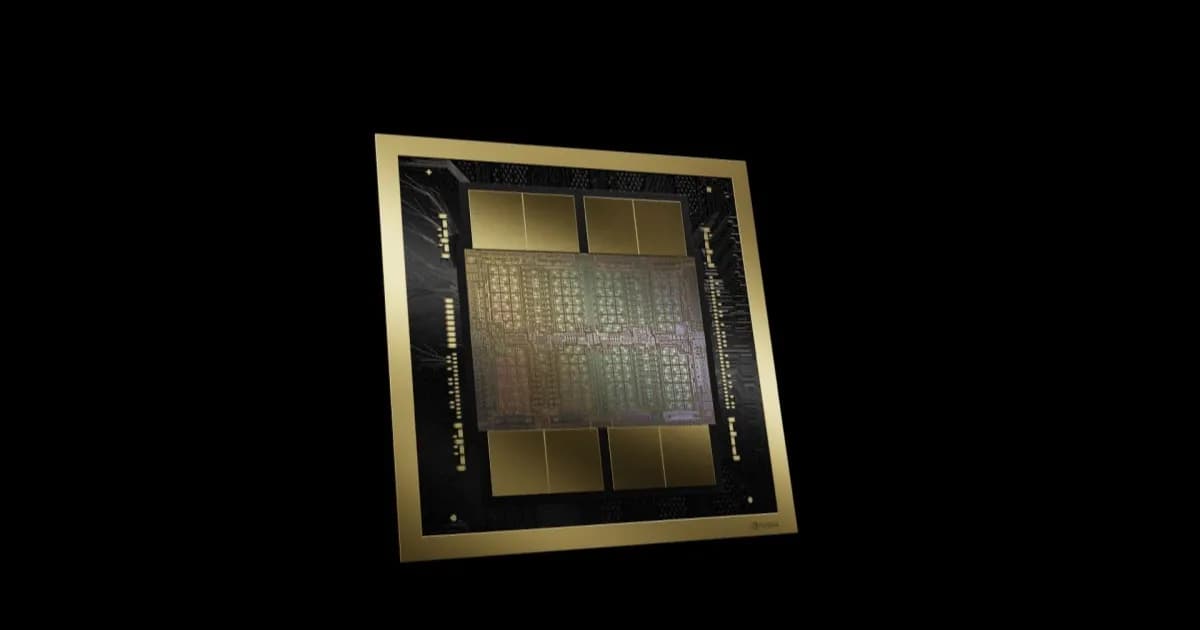
Pencapaian tersebut diumumkan Tufa Labs pada 19 November 2026. Paket lengkap tufazip berukuran 105,39MB setelah optimasi, termasuk model starter pre-trained berukuran kecil 4,33MB yang disimpan dalam presisi rendah atau quantized untuk menghemat ruang. Model starter itu wajib ada agar file bisa dibuka kembali. Seluruh proses memakai model Transformer 163 juta parameter sebagai predictor, dan kompresi maupun dekompresi serupa membutuhkan dua GPU Nvidia B200 selama sekitar satu minggu.
Yang membuat tufazip berbeda adalah posisinya di papan peringkat. Tufa Labs menyebut semua 12 entri yang kini berada di atasnya menggabungkan Transformer dengan model buatan tangan. tufazip justru berjalan tanpa model kompresi tradisional yang membantu, sehingga menjadi hasil terkecil dari entri yang murni mengandalkan neural network. Pendekatan berbasis komputasi seperti ini juga sejalan dengan tren infrastruktur AI yang makin bergantung pada akselerator kelas atas, seperti terlihat pada Harga GPU Naik yang memengaruhi biaya operasional model besar.
Cara Kerja Model yang Belajar Saat Kompresi
tufazip bukan chatbot maupun AI cloud. Ia adalah model bahasa mandiri yang belajar secara on the fly. Karena kompresinya lossless, tidak ada risiko data hilang dalam proses, dan konsekuensinya pembaruan predictor harus sepenuhnya deterministik. Pelatihan berlangsung dalam dua tahap. Model starter berukuran 34 juta parameter dilatih offline sebelum kompresi dimulai. Setelah itu model penuh mulai belajar online dengan memprediksi setiap token dan melatih diri pada token tersebut, sementara sisi unpacking mengulang langkah yang sama dan membangun ulang model bersamaan dengan teks.
Model penuhnya adalah Transformer 12 layer, artinya ada 12 tahap yang dilalui setiap prediksi. Model starter hanya menyimpan dua tahap yang sudah terlatih, lalu menyalinnya bolak-balik untuk mengisi seluruh 12 tahap saat model penuh berjalan di memori, dan setiap salinan terus belajar sendiri. Karena itu ukuran total hanya mencakup teks terkompresi, program unpacking, dan file yang dibutuhkannya termasuk starter, bukan model penuh yang sudah dilatih.

Sebelum versi 105,39MB, tufazip versi pertama yang sepenuhnya belajar online datang dengan ukuran 105,98MB. Versi itu sempat menempati peringkat kedua saat disubmit pada awal September 2026. Pada pembaruan benchmark 19 November 2026, versi 105,39MB berada di posisi ke-13. Perlu ditegaskan bahwa ini adalah benchmark khusus teks, bukan untuk file media.
Baca Juga:
Beban Komputasi dan Temuan Tak Terduga
Menjalankan tufazip bukan perkara ringan. Pada mesin uji dengan dua GPU Nvidia B200 plus dua CPU Intel Xeon Platinum 8570, kompresi versi 105,39MB membutuhkan 631.548 detik dan dekompresi 645.748 detik, atau sekitar 7,3 hari dan 7,5 hari, belum termasuk pelatihan offline model starter. Versi pertama yang sepenuhnya online memerlukan 647.595 detik untuk kompresi dan 630.136 detik untuk dekompresi. GPU mencapai puncak 43,37 GiB VRAM di antara keduanya, dengan penggunaan memori total termasuk GPU sekitar 68.525 MiB saat kompresi dan 73.748 MiB saat dekompresi.
Eksperimen ini juga memunculkan sejumlah temuan yang berlawanan dengan asumsi umum. Vocabulary yang lebih kecil justru membantu: tokenizer 4K kata mengalahkan 8K dan 16K. Memberi token khusus untuk markup XML Wikipedia malah memperburuk kompresi. Ukuran model juga tidak selalu berbanding lurus dengan hasil, karena model 267 juta parameter tampil sedikit lebih buruk dibanding model 188 juta parameter pada dataset ini. Pada versi file yang lebih kecil, 100MB, keuntungan mulai mendatar di sekitar 77 juta parameter.
Sebuah run yang dimulai dari model offline enam layer berukuran lebih besar memprediksi lebih baik dengan payload hanya 99,17MB, tetapi bobotnya yang lebih besar membuat ukuran file total lebih besar dibanding run yang sepenuhnya online. Meningkatkan kompresi pun berbiaya mahal, seperti melebarkan jendela teks yang sudah diproses dari 15 menjadi 35 juta token yang hanya memangkas payload 1,21% dengan konsekuensi komputasi 40% lebih besar. Trade-off enam layer itu disebut Tommy He sebagai pertanyaan riset berikutnya, yakni seberapa besar kualitas prediksi yang bisa dipertahankan model lebih kecil, sehingga titik akhirnya menjadi keseimbangan antara kualitas prediksi dan ukuran model.
Perlu dicatat, tufazip ditujukan untuk keperluan riset dan bukan produk. Sifat eksperimental ini menegaskan bahwa inovasi kompresi berbasis neural network masih berada di ranah laboratorium, bukan alat konsumen sehari-hari. Bagi pengguna yang mengikuti perkembangan perangkat keras pendukungnya, konteks soal kesiapan platform bisa ditelusuri lewat Pembaruan BIOS dan CPU Intel Baru yang menunjukkan arah ekosistem komputasi ke depan.
Dengan hasil 105,39MB, tufazip menunjukkan bahwa kompresi lossless berbasis Transformer murni sudah mampu bersaing di benchmark teks, meski harganya berupa kebutuhan komputasi besar dan waktu proses berhari-hari. Bagi dunia riset, temuan bahwa model lebih kecil dan vocabulary lebih ringkas bisa lebih efektif menjadi sinyal bahwa optimasi bukan sekadar menambah sumber daya.


Komentar
Belum ada komentar.