Telset.id – Seorang pengacara bernama Nick Mermiges meningkatkan kemampuan server AI pribadinya dengan menambah dari delapan menjadi 12 GPU Nvidia V100 bekas. Konfigurasi baru ini memungkinkannya menjalankan seluruh expert DeepSeek V4.1 Flash pada presisi 4-bit NVFP4, dengan performa hingga 184 token per detik untuk kode dan waktu jawab dokumen panjang yang jauh lebih cepat.
Langkah ini menjadi sorotan karena Mermiges mengklaim sistemnya mampu melampaui performa stack DGX Spark yang dipublikasikan dalam hal decoding satu permintaan, dengan harga setengah dari tiga unit DGX Spark, berdasarkan biaya 9.450 dolar AS yang ia keluarkan. Peningkatan ini merupakan tahap ketiga dari eksperimen yang sebelumnya sudah ia lakukan dengan menambah memori dan perbaikan lain.
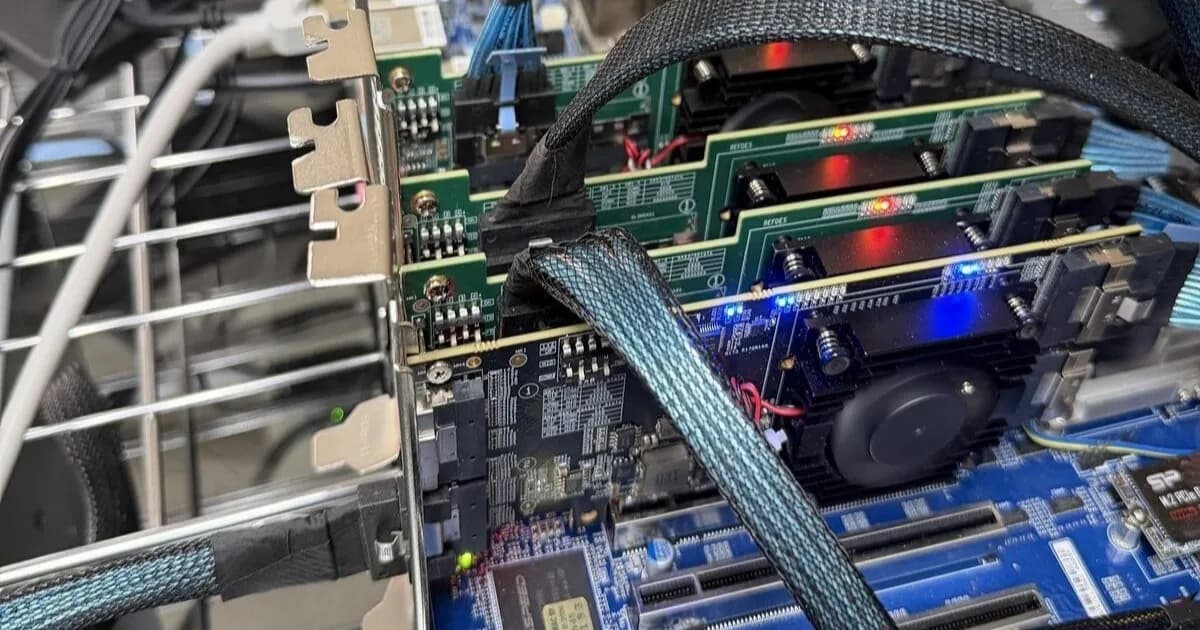
Upgrade terbaru melibatkan papan V100 ketiga, sehingga total menjadi 12 kartu dengan empat kartu per papan. Delapan kartu 32GB sebelumnya hanya mampu mengelola 254 GiB, sementara expert untuk model pilihan dengan rilis NVFP4 dari Nvidia membutuhkan 278,9 GiB. Sebelumnya, ia harus mengompres semua expert pada presisi 2-bit, dengan 5.949 expert atau sekitar 38,7% yang paling sering digunakan dialihkan ke NVFP4 hingga kartu penuh.

Kini, seluruh 15.360 expert dapat berada di kartu dalam presisi penuh sesuai keinginannya, dengan “tidak ada yang dikompresi lebih lanjut,” menurut repo GitHub-nya. Dalam tulisan panjang di situsnya, ia menyebut nilai expert “setara dengan yang ada di rilis DeepSeek sendiri,” meskipun bagian lain dari model menggunakan bentuk yang lebih ringkas.
Baca Juga:
Keterbatasan V100 dan Trik Software
Pengamat akan menyadari keterbatasan V100 yang dijelaskan sendiri oleh Mermiges: V100 tidak memiliki tensor core FP4 atau FP8. Setiap angka NVFP4 harus di-unpack dalam software terlebih dahulu, lalu dikonversi ke half precision. Expert yang ringkas tetap menguntungkan “karena kartu membaca lebih sedikit byte, bukan karena komputasinya lebih cepat.” Hal ini menjelaskan mengapa kartu dari 2018 dapat menjalankan format dari era Blackwell.
Lapisan model kembali dibagi di antara papan, kali ini dengan rentang 0–13, 14–27, dan 28–39, dan setiap bagian papan dibagi di antara empat kartunya. Kartu pada satu papan berbagi link cepat Nvidia atau NVLink, sementara serah terima antar papan melintasi PCIe host melalui dua switch PCIe terpisah. Dua papan pertama berbagi switch PEX88096 sehingga serah terima mereka tetap di dalamnya, tetapi papan ketiga berada di belakang PLX 8749 terpisah, sehingga serah terima kedua juga harus melintasi bridge PCIe host yang menambah latensi.

Semua usaha ini terbayar karena dengan pengaturan berbeda — batas daya tiap kartu dinaikkan dari 150 W menjadi 175 W dan batas clock diturunkan dari 1.522 MHz menjadi 1.452 MHz — ada peningkatan performa yang signifikan sekaligus presisi. Pengukurannya menunjukkan token kode pertama dengan konteks 256K berada di 58 detik, hampir dua kali lebih cepat dari 108,4 detik setelah upgrade sebelumnya.
Pembacaan prompt berada di “sekitar 4.500 token per detik” di atas 32K, lebih dari dua kali lipat dari sekitar 2.200 token per detik pada build pertamanya, meskipun batas daya yang lebih tinggi kemungkinan turut berkontribusi. Decode kode, sementara itu, 23% lebih cepat pada 1K, tetapi tidak menunjukkan keuntungan nyata pada 32K ke atas, sehingga keuntungan sebenarnya adalah berkurangnya waktu tunggu untuk token pertama.
Optimasi, Batas Daya, dan Rencana Berikutnya
Ada keinginan untuk mendapatkan lebih banyak dari sistem dengan mendorong setiap kartu ke 200 W selama sehari, tetapi “host trip sekali di bawah empat chat panjang sekaligus,” yang mengindikasikan konsumsi daya mungkin terlalu tinggi. Ia juga berupaya mengoptimalkan setup semaksimal mungkin, tetapi empat optimasi — conversation store yang menyimpan ke disk, serah terima antar bagian yang lebih ramping, pengemasan expert yang lebih ketat, dan aritmetika four-card-sum eksak — harus dinonaktifkan karena tidak memenuhi target.
Teknik umum lainnya adalah menjalankan beberapa permintaan sekaligus, yang biasanya menghasilkan peningkatan kecepatan. Dalam kasus ini, tiga permintaan pada 128K mencapai sekitar 360 token per detik secara total untuk kode dan 213 untuk legal. Meski demikian, “ini bukan mesin batched-decode; lebih banyak permintaan daripada bagian tidak banyak berguna.” Namun, itu mungkin menjadi agenda berikutnya, karena ia berencana mempelajari batched decoding, “satu hal yang dimiliki Sparks yang saya inginkan,” tulisnya di Reddit.

Selain itu, ada rencana untuk mengaktifkan conversation store agar dokumen suatu perkara dapat bertahan setelah restart. Meskipun ia mengakui angka-angka tersebut tidak membuktikan “kualitas jawaban dalam penggunaan,” setup ini telah menjadi mesin DeepSeek default-nya sejak Senin, dan ia menyebut model tersebut sebagai yang pertama “yang bekerja seperti Opus 4.6” baginya.
Eksperimen Mermiges menunjukkan bahwa GPU bekas dari generasi lama masih dapat dimanfaatkan untuk menjalankan model bahasa besar dengan presisi tinggi, asalkan konfigurasi perangkat keras dan software dirancang dengan cermat. Pendekatan ini menjadi alternatif bagi pengguna yang ingin membangun server AI pribadi tanpa harus membeli perangkat baru yang jauh lebih mahal.

Bagi kalangan profesional, termasuk di sektor hukum yang mulai melirik pemanfaatan AI, kemampuan menjalankan model secara lokal dengan konteks panjang menjadi relevan. Namun, seperti dicatat Mermiges, angka performa belum menjamin kualitas jawaban dalam praktik. Verifikasi tetap menjadi tanggung jawab pengguna, sejalan dengan pembahasan mengenai adopsi AI di sektor hukum yang menekankan peran pengacara dalam memeriksa hasil.
Konfigurasi 12 kartu V100 ini juga memperlihatkan bahwa batas antara perangkat keras konsumen, bekas, dan kelas enterprise semakin kabur ketika software mampu mengompensasi keterbatasan hardware. Dengan biaya 9.450 dolar AS, Mermiges membuktikan bahwa perakitan mandiri dapat bersaing dengan solusi komersial dalam skenario tertentu, meski dengan trade-off pada latensi dan konsumsi daya.
Ke depan, fokus pada batched decoding dan conversation store akan menentukan seberapa jauh sistem ini dapat berkembang. Untuk saat ini, setup tersebut telah menjadi mesin andalan sehari-hari bagi Mermiges, sekaligus contoh nyata bagaimana eksperimen komunitas lokal AI mendorong pemanfaatan perangkat keras yang ada.


Komentar
Belum ada komentar.