Telset.id – Semakin banyak orang menyerahkan penalaran abstrak kepada large language models (LLM), namun makna dan nuansa kata yang presisi berisiko hilang saat model AI memproses, merangkum, dan mengedarkan ulang kata-kata tersebut secara berulang. Kondisi ini dikenal sebagai semantic erosion, sebuah kesalahan struktural, bukan “halusinasi” di mana model AI mengarang fakta yang salah. Output yang dihasilkan tetap jelas, tetapi konteksnya terkupas sehingga maknanya berubah.
Semantic erosion menjadi hambatan utama yang harus diakali pengembang LLM. Sebab, manusia bukan robot yang memformalkan setiap kalimatnya. Kita berbicara dengan nada budaya dan situasional yang tidak tertulis. Contohnya, di sejumlah budaya, pertanyaan “Have you eaten yet?” tidak berarti menanyakan apakah seseorang sudah makan, melainkan cara sopan menyapa “How are you doing?”.
LLM bisa melewatkan nuansa itu dalam sebuah esai, menafsirkannya secara literal, dan memberi output yang salah. Bila AI Model A menafsirkan “Have you eaten yet?” secara literal, ia meneruskan tafsiran itu ke Model B, yang lalu meneruskannya ke Model C. Pada lapisan ketiga, nuansa tersebut hilang. Model AI memberi output yang koheren, tetapi keluar dari konteks budaya dan situasional.
Bagaimana Semantic Erosion Menggerus Akurasi LLM
Semakin banyak informasi diproses LLM, salah tafsir kecil bisa menumpuk dan memengaruhi kualitas output. LLM dapat salah membaca konteks manusia atau menggantinya dengan sinonim, menghasilkan output yang fasih dan gramatikal tetapi tidak sesuai keinginan pengguna.
Contoh lain yang menggambarkan hal ini adalah laporan keuangan tahunan sebuah perusahaan yang dianalisis model AI multi-agen. Agent A salah menafsirkan “net profit” sebagai “operating profit”, padahal keduanya berbeda. Operating profit adalah total keuntungan perusahaan dari aktivitas bisnisnya, sedangkan net profit adalah sisa setelah dikurangi pajak, depresiasi, pembayaran utang, dan biaya lain dari operating profit.
Agent A meneruskan salah tafsir itu ke Agent B sehingga data terdegradasi. Setelah Agent C, D, dan E menganalisis laporan keuangan tersebut, wawasan yang diekstrak pun menjadi salah. Ini bukan kesalahan eksplisit, melainkan kesalahan senyap yang mudah terlewat pengguna, dan wawasan keliru bisa memicu keputusan yang keliru.
Bila dibiarkan, semantic erosion menurunkan akurasi output model AI. Sedikit salah tafsir di sini, sedikit lagi di sana, dan model AI bisa menjadi terlalu tidak andal untuk dipercaya pengguna. Karena itu, pengembang LLM harus menangani masalah ini.
Terdapat pula intent compression paradox. Manusia menambahkan emosi, pemahaman, serta konteks budaya dan lingkungan, di mana nada suara saja bisa mengubah makna kalimat. Contohnya, “We need to talk” bisa menandakan kepedulian bila diucapkan dengan nada lembut, tetapi terasa seperti konfrontasi bila diucapkan keras dan bernada tinggi. “You can say that again” menandakan kesepakatan ramah saat diucapkan hangat dan lembut, tetapi bisa terdengar menantang bila diucapkan lantang.
Persoalannya, manusia meniru cara bicara satu sama lain saat berbicara dengan model AI, meski model tersebut tidak memahami emosi. Model AI menganalisis kata secara statistik dan memberi output kuantitatif. Inilah paradoks: semakin dioptimalkan sebuah model AI untuk memberi jawaban paling analitis, semakin agresif ia bisa salah menafsirkan niat manusia. Pengembang LLM biasanya memampatkan prompt untuk menghemat biaya token, tetapi semakin berat niat manusia dimampatkan, semakin tinggi peluang model menghasilkan jawaban yang tidak andal.
Strategi Pengembang LLM Mengatasi Semantic Erosion
Tidak ada strategi tunggal yang menjadi solusi pamungkas untuk menangani semantic erosion pada model AI. Para pengembang menggabungkan berbagai metode. Berikut pendekatan yang mereka terapkan.
1. Penyaringan data
Fondasi setiap model AI adalah dataset pelatihannya, sehingga penyempurnaan pemahaman niat manusia dimulai dari sini. Penggunaan dataset yang lebih terkurasi, seperti jurnal peer-review, diskusi pakar, artikel mendalam, dan literatur, alih-alih dataset generik, membantu model AI memahami konteks lebih baik. Dataset terkurasi mengandung informasi kaya dan berintegritas tinggi yang membantu model mengenali analisis berbasis konteks serta penalaran yang sehat, bukan sekadar mengambil klaim tak terverifikasi.
Dataset terkurasi lebih mahal daripada dataset generik, tetapi imbalannya adalah akurasi dan keandalan yang lebih baik. Seluruh dataset tidak harus terkurasi, namun memasukkan volume signifikan dataset terkurasi membantu LLM memahami konteks jauh lebih baik.
Untuk menjaga integritas dataset terkurasi, pengembang dapat menyematkan watermark kriptografis atau statistik (misalnya SynthID dari Google) ke dalam output AI. Watermark ini memungkinkan model mengenali outputnya sendiri dan menghindari pelatihan berbasis output tersebut, mencegah “model collapse” di mana LLM menurun kualitasnya setelah dilatih dengan data hasil produksinya sendiri. Pendekatan lain adalah membangun pipeline dataset pelatihan yang hanya memuat data sebelum 2023, tahun ketika LLM menjadi arus utama dan web mulai dibanjiri konten buatan AI.
2. Solusi arsitektural
Pengembang dapat melawan semantic erosion lewat desain arsitektur model AI yang strategis. Misalnya, model AI dilarang menebak makna field data dan sebagai gantinya menggunakan platform semantik lokal (misalnya SqIDBM) untuk memetakan kueri data ke metrik terstruktur, bukan ke tabel database mentah yang bisa membuat model mengekstrak data keliru bila dibiarkan sendiri. Platform semantik di tengah bertindak seperti penerjemah yang memberi tahu model apa yang harus di-output.
Pengembang juga dapat menerapkan autonomous drift detection dan observability tingkat sesi, di mana sistem independen memeriksa apakah output agen AI mulai menyimpang dari baseline semantik yang ditetapkan. Alih-alih hanya memantau panggilan API terisolasi, pendekatan ini melacak respons agen AI di sepanjang percakapan dan berbagai alur kerja. Jika terdeteksi penyimpangan konteks, koreksi otomatis dapat dipicu, seperti memindahkan tugas ke model lain, menyuntikkan prompt yang lebih sadar konteks, dan menghentikan loop berulang untuk menghemat biaya token.
Pengembang juga bisa memperkenalkan loss function yang memberi penalti pada agen AI karena terlalu seragam, memaksa mereka mempertahankan entropi statistik (keberagaman) dalam output. Tanpa penalti ini, model AI dapat hiper-optimasi hingga menemukan satu jawaban sukses untuk sebuah kueri, lalu mengulanginya tanpa henti untuk kueri serupa meski konteksnya berbeda. Penalti entropi mendorong agen AI mendistribusikan probabilitas ke berbagai opsi alih-alih menaruh keyakinan 100% pada satu respons.
Beralih dari 1 ke 5 agen menghadirkan kompleksitas koordinasi yang tinggi. Bayangkan potensi kesalahan state, race condition, dan titik kegagalan sebuah model AI, lalu kalikan dengan jumlah model pangkat dua. Berpindah ke 3 agen meningkatkan kompleksitas menjadi 9, dan ke 5 agen menjadi 25. Riset menunjukkan 36,9% kegagalan sistem multi-agen disebabkan oleh ketidakselarasan koordinasi. Agen yang berbagi memori yang sama bisa membaca data usang dari lapisan cache. Berbeda dengan model AI tunggal dengan batas API ketat, sistem multi-agen dapat berputar tanpa henti dan salah menafsirkan konteks. Untuk mengatasinya, pengembang menggunakan koordinator pusat yang memecah kueri pengguna, menugaskan bagian-bagian secara dinamis atau berurutan ke agen berbeda, lalu mengagregasi hasilnya.
Baca Juga:
3. Solusi algoritmik
Pendekatan algoritmik mencegah semantic erosion dengan menyuntikkan kekakuan matematis ke dalam model untuk menegakkan konsistensi semantik, membatasi distribusi probabilitas, dan membatasi terjadinya halusinasi. Salah satu caranya adalah melengkapi pencarian jarak vektor murni dengan jalur knowledge graph yang presisi pada agen AI. Ini membantu agen AI beralih dari sekadar mencari kemiripan semantik ke penalaran terstruktur berbasis fakta relasional.
Jalur knowledge graph menghubungkan entitas (seperti tempat, orang, dan objek) dengan edge berarah, memungkinkan agen mengikuti jalur multi-hop yang telah ditetapkan, seperti Author > Book > Chapter > Quote, untuk mengambil fakta. Pencarian jarak vektor tidak sepenuhnya ditinggalkan karena tetap penting untuk jawaban rutin bergaya naratif. Model hibrida pun dipakai: jarak vektor menangani kueri rutin, sementara jalur knowledge graph menangani kueri yang lebih kompleks.
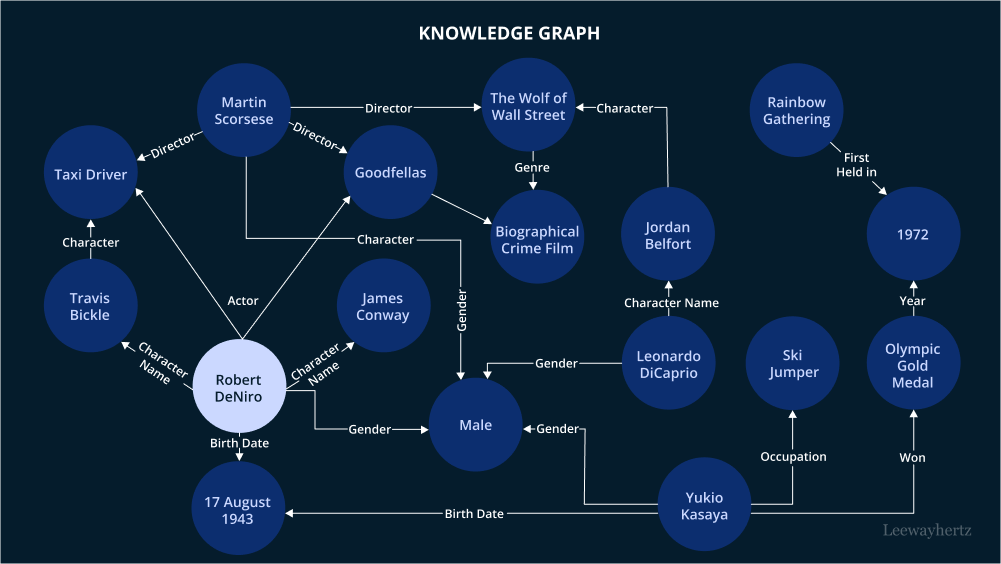
Pengembang juga menggabungkan statistical machine learning (prediksi berbasis data) dengan batasan aljabar hard-coded (batas matematis) yang tidak bisa dilewati. Contohnya, model AI yang menyimulasikan reaksi kimia akan memakai statistical machine learning untuk menyimulasikan reaksi, dan lapisan aljabar yang mengikatnya pada hukum Kekekalan Massa dan Energi, yang menyatakan total massa dan energi dalam sistem terisolasi tetap konstan dan tidak dapat diciptakan atau dimusnahkan. Dalam istilah matematika, E = mc², di mana E adalah energi total, m adalah massa, dan c adalah kecepatan cahaya dalam ruang hampa (3 x 10⁸ m/s).
Batasan aljabar tersebut memastikan model AI tidak melanggar hukum fisika dengan menciptakan atau memusnahkan energi kimia saat menyimulasikan reaksi. Semantic erosion tidak akan membiarkan model AI menghasilkan hasil yang mustahil secara fisik dengan energi lebih atau kurang dari reaktan asli dalam proses kimia.
Saat pelatihan, pengembang juga membatasi reward function model AI pada hasil terkompilasi, atau token deterministik, yang dikenal sebagai mekanisme Outcome-based reward. Ini menekankan hasil dan kebenaran di atas kepatuhan format, di mana model harus lulus unit test, bukan sekadar terdengar meyakinkan padahal bisa sangat keliru. Model AI pandai melakukan “reward hacking”, di mana mereka menghasilkan teks koheren tetapi sangat salah, dan inilah yang berada di balik halusinasi yang sering dilihat pengguna. Membatasi reward function pada token deterministik mencegah halusinasi dan semantic erosion.
4. Pendekatan Human-in-the-Loop (HITL)
Model AI mungkin bekerja mandiri setelah pelatihan, tetapi menyertakan manusia dalam loop tetap bermanfaat. Pendekatan human-in-the-loop (HITL) menuangkan penilaian manusia langsung ke dalam pipeline data AI untuk mencegah semantic erosion.
Saat melabeli data pelatihan, pakar domain dapat turun tangan untuk mengaitkan ulang token yang menyimpang ke definisi dunia nyata, alih-alih membiarkan output AI-ke-AI rekursif yang mudah salah tafsir. Platform seperti Mercor telah membangun bisnis besar dari mempekerjakan pakar domain (seperti software engineer, pengacara, dokter, dan investment banker) untuk melabeli data bagi laboratorium AI. Mercor sendiri memiliki puluhan ribu talenta yang menyempurnakan data untuk banyak pengembang model AI, termasuk Anthropic (Claude) dan OpenAI (ChatGPT), dua yang terbesar.
Pengembang juga menyuntikkan umpan balik yang kerap divalidasi manusia untuk mencegah loop semantic erosion, di mana model AI berlatih pada data buatan AI dan perlahan kehilangan sentuhan dengan data manusia nyata. Bila dibiarkan tanpa umpan balik manusia, bias kecil, halusinasi, dan kesalahan bisa menjadi data fondasi untuk melatih AI berikutnya, dan kasus-kasus pinggiran menghilang sehingga model AI melupakan data dasarnya. Namun, pengembang secara rutin menyuntikkan data yang lebih kaya konteks untuk mencegahnya.
Terdapat pula pendekatan Reinforcement Learning from Human Feedback (RLHF), metode pelatihan di mana pakar manusia menilai output model AI untuk keselarasan dengan nilai dan preferensi yang dinyatakan. Model belajar dari proses ini untuk memberi output yang selaras dengan niat manusia, bukan sekadar mengandalkan aturan hard-coded. RLHF berlangsung pada tahap pasca-pelatihan, setelah model melewati pra-pelatihan untuk membangun pengetahuan dasar, dilanjutkan tahap supervised fine-tuning (SFT) yang mengajarkan model memformat jawaban dengan benar dan bertindak seperti asisten. Kemudian RLHF masuk untuk menyelaraskan model dasar dengan nilai manusia.
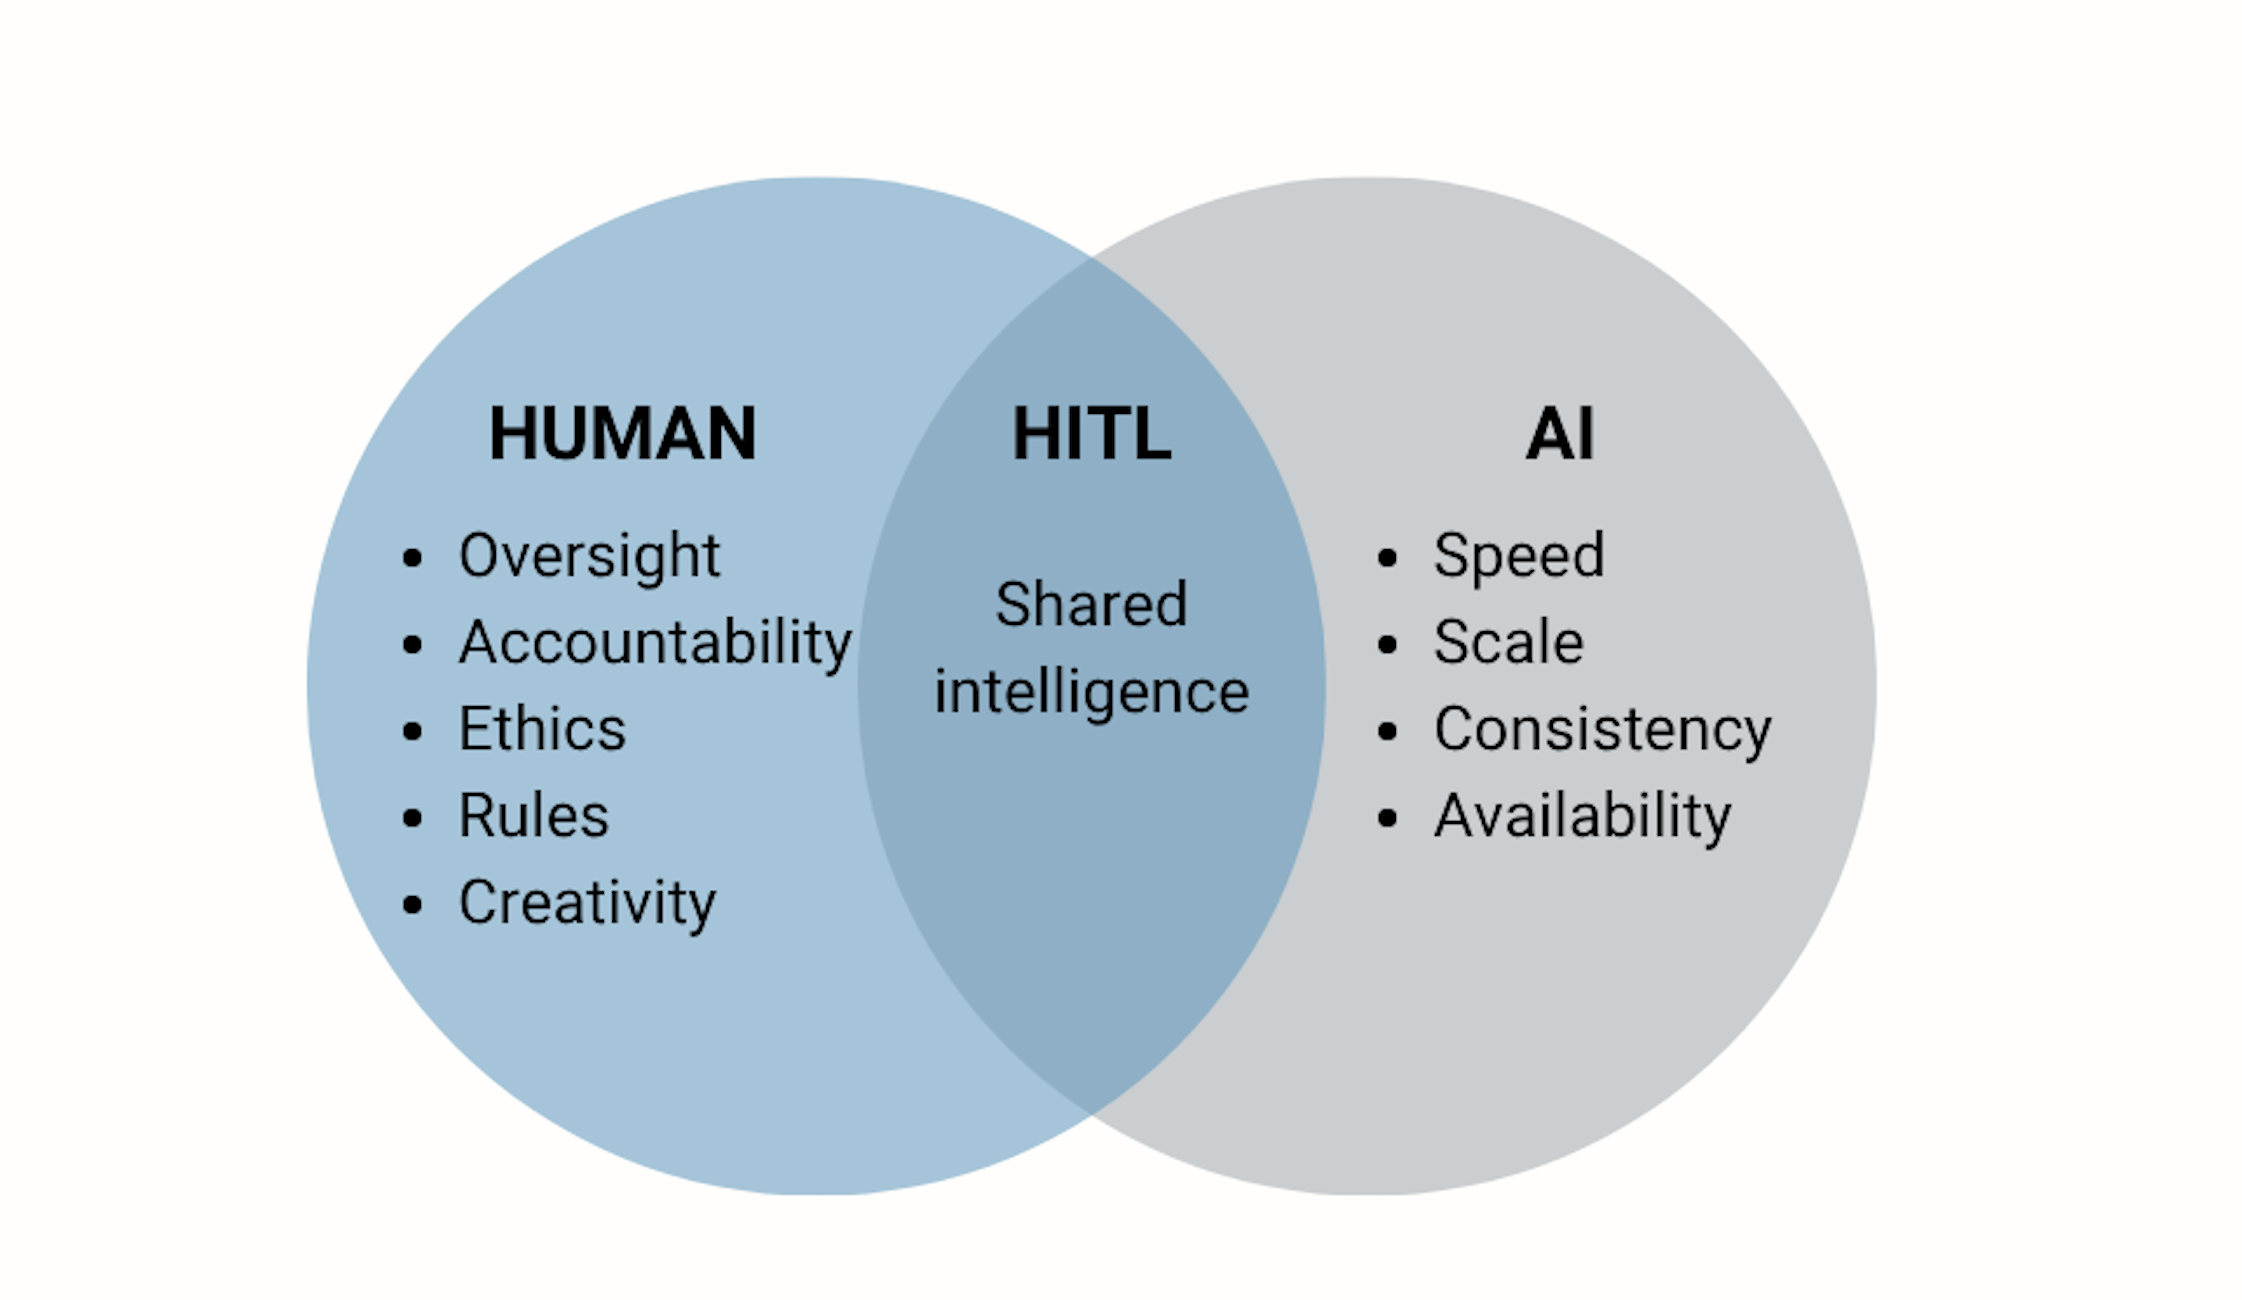
Proses pelatihan AI secara luas tidak pernah benar-benar berakhir, bahkan ketika sebagian besar pekerjaan dilakukan pada tahap awal. Semantic erosion akan selalu menjadi isu yang membayangi dan harus ditangani. Untungnya, pengembang telah membuktikan berbagai strategi untuk menanganinya dan menjaga model tetap seakurat mungkin.
Bagi pengguna yang ingin memahami lebih jauh soal tata kelola dan kebijakan teknologi, isu seputar larangan perangkat juga menjadi perhatian, seperti langkah TP-Link Bangun Router di AS. Selain itu, ada pula upaya TP-Link Pindahkan Produksi demi mematuhi regulasi.
[ META_DESCRIPTION ]
Semantic erosion membuat makna kata hilang saat LLM memproses ulang informasi. Simak penyebab dan strategi pengembang AI mengatasinya.


Komentar
Belum ada komentar.