Telset.id – SK hynix merancang core khusus bernama Hynix Transaction Processing Unit (H-TPU) untuk mengurangi ketergantungan pada core CPU yang boros daya di dalam SSD. Core buatan sendiri ini diklaim hanya menarik sekitar 2,5% daya core CPU general-purpose, dengan luas area sekitar 4% saja. Rencana tersebut diungkapkan di tengah keterbatasan daya dan area yang dihadapi CPU pengendali SSD saat ini.
H-TPU bukan akselerator AI. Core ini dirancang membantu pekerjaan repetitif yang biasanya ditangani SSD, yang menuntut lebih banyak core pada controller seiring kecepatan drive meningkat. Core-core baru ini ditempatkan dalam klaster dan menangani I/O rutin dengan pipeline empat tahap, in-order, sementara tugas manajemen tetap diserahkan kepada CPU Arm tradisional.
Wakil Presiden desain system-on-chip (SoC) SK hynix, Koo In-jae, menyampaikan hal ini dalam ISOCC 2026, International SoC Design Conference, pekan lalu. Dalam presentasi bertajuk “From SSD Controllers to AI Memory SoCs”, ia menyebut CPU pengendali SSD sudah mencapai batas pada daya dan area. Bandwidth PCIe berlipat ganda setiap generasi, sementara clock dan kemampuan kontrol CPU pengendali dilaporkan tidak dapat mengimbanginya.
Baca Juga:
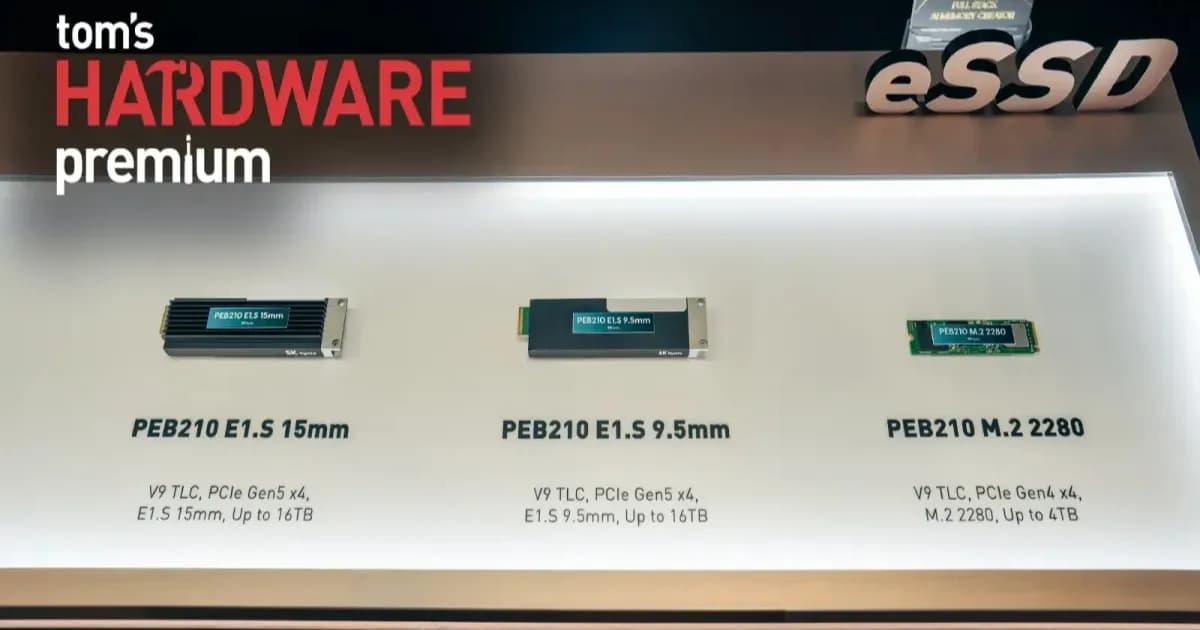
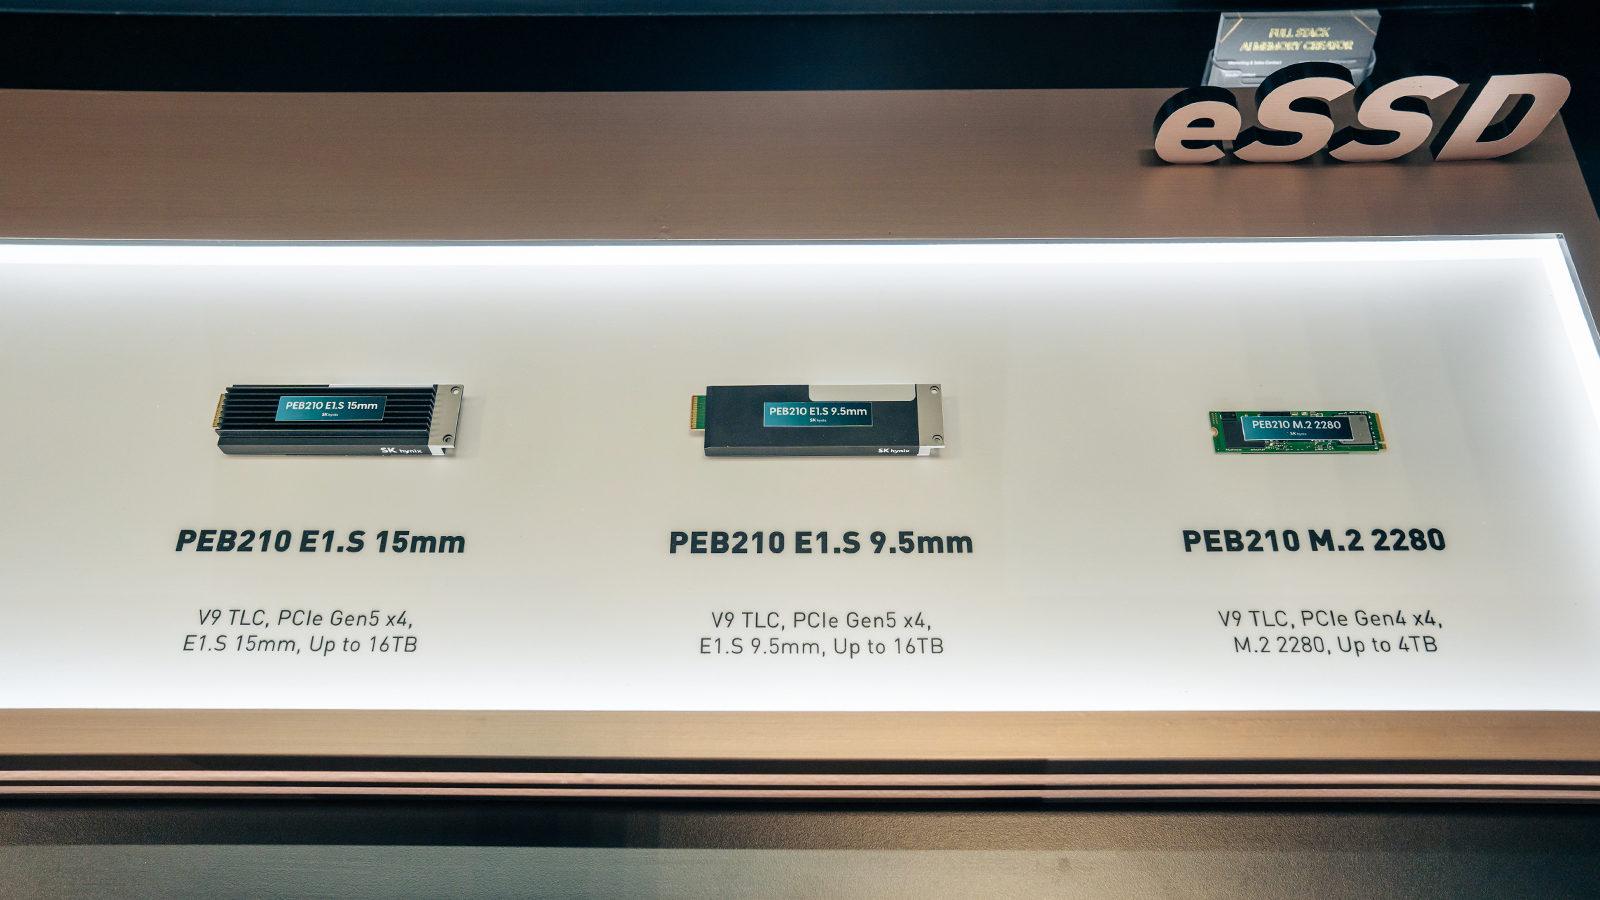
SK hynix dilaporkan berencana menerapkan H-TPU di seluruh portofolio produk NAND-nya, termasuk controller SSD enterprise generasi berikutnya. Di segmen inilah pengejaran IOPS tanpa henti membuat masalah scaling paling terlihat. Komentar Koo menyoroti persoalan scaling yang tercermin dari solusi “lebih banyak core” pada produk pesaing.
Sebagai perbandingan, Marvell PCIe 6.0 Bravera SC6 memakai 12 core Cortex-R82 dalam dua klaster enam core, ditambah tiga core Cortex-M7 dan satu Cortex-M3 untuk keamanan. Bandingkan dengan pendahulunya, Bravera SC5 berbasis PCIe 5.0, yang mencantumkan 10 core Cortex-R8 dan Cortex-M7 plus satu Cortex-M3 untuk keamanan. Jumlah core memang naik seiring kecepatan PCIe karena kebutuhan.
Desain H-TPU dan Skala Penerapannya
Jawaban SK hynix adalah core rancangan sendiri: H-TPU, yang dibuat kecil dan programmable. Core ini hadir dengan compiler khusus dan perkakas pengembangan lain untuk kode terspesialisasi. H-TPU disebut memakai pipeline empat tahap dengan eksekusi in-order atau sekuensial. Core ini bukan superscalar, tidak memakai unit out-of-order, dan tidak boleh disamakan dengan tensor processor untuk AI.
H-TPU dirancang menangani pemrosesan perintah baca dan tulis, mengelola metadata, serta menangani kontrol buffer, semuanya tugas repetitif. Kontrol penyimpanan membutuhkan lebih dari 100 fungsi terperinci, yang tidak ideal untuk CPU monolitik. Alih-alih itu, SK hynix memecah fungsi-fungsi tersebut dan menyebarkannya ke “puluhan klaster TPU kecil”, menurut ZDNet Korea. Setiap H-TPU punya tugas terspesialisasi.
Total jumlah H-TPU lebih dari 100, sementara jumlah fungsi di atas adalah angka terpisah. Namun, belum ada detail berapa banyak core yang ada di setiap klaster. CPU utama tetap menangani error recovery dan exception handling, plus manajemen kebijakan penyimpanan. Artinya, H-TPU melengkapi CPU: melakukan offloading, bukan menggantikan. Desain ini membuat core yang tidak dibutuhkan oleh suatu I/O menjadi idle, yang dilaporkan masuk ke mode daya minimum.
Kedua laporan tersebut tidak menyebut core CPU apa yang berada di balik angka daya 2,5% dan area 4% milik SK hynix. Memecah beban kerja dengan cara ini bukan ide baru. Phison CoXProcessor, yang memasangkan core Cortex-R5 dengan hardened macro untuk meng-offload firmware repetitif pada kecepatan wire, sudah ada di produk selama beberapa waktu. Controller SSD Phison E18 memakai dua core Cortex-R5 ber-clock lebih rendah untuk melengkapi tiga core utamanya.
Di sisi enterprise, Phison X1 memakai dua core Cortex-R5 plus hingga 32 “micro core”, masing-masing didedikasikan untuk satu atau dua tugas. H-TPU membawa pendekatan ini ke skala yang lebih besar. Meski paparannya minim detail, ditemukan sejumlah paten SK hynix yang menjabarkan pemisahan serupa antara core kecil dan CPU.
Paten, Hardware Automation, dan Jalur HBF
Paten AS 11.675.537, yang pertama kali diajukan di Korea pada November 2020, menjabarkan control plane yang dijalankan CPU dan I/O plane berisi banyak prosesor kecil, yang dikelompokkan ke dalam empat grup berdasarkan tugas. Sebuah perintah melewati keempatnya secara berurutan: host untuk ingestion, cache, map, dan NVM menuju NAND. Para prosesor “mengonfigurasi pipeline untuk operasi data I/O” dengan cara ini, sehingga CPU menangani setiap pengecualian.
Pipeline tersebut berjalan di banyak core dan tidak terkait dengan pipeline empat tahap di dalam setiap H-TPU. Dalam contoh paten itu, setiap core kecil berukuran sekitar “200.000 logic gate”, bukan “tujuh juta logic gate” milik CPU, atau sekitar 2,9% dari jumlah gate CPU. Elemen-elemen ini tidak tetap, karena “firmware dapat dijalankan di masing-masing TPU”, membuatnya lebih adaptif dibanding sirkuit hardware yang oleh paten disebut “sulit dimodifikasi”.
Paten tersebut menuliskan TPU sebagai “Tensor Processing Units”, tetapi sekali lagi, ini tidak boleh disamakan dengan akselerator AI. H-TPU berbagi pendekatan programmable itu, namun langkah berikutnya yang dijelaskan SK hynix memindahkan sebagian pekerjaan rutin ke hardware tetap. Langkah berikutnya adalah hardware automation (HWA), dengan pemrosesan perintah, pencarian alamat, dan penyalinan buffer dipindahkan ke sirkuit khusus. CPU dan H-TPU tetap menangani pengecualian dan keputusan kebijakan utama.
Beralih ke kerangka ini dimaksudkan menjaga waktu penyelesaian tetap dapat diprediksi, yang diperlukan pada I/O, terutama untuk SSD enterprise ber-IOPS tinggi saat ini. SK hynix pernah mengajukan paten jalur hardware tetap sebelumnya, lewat pengajuan 2014 oleh unitnya di San Jose dan, kemudian, paten AS 12.216.914 yang pertama kali diajukan di Korea pada 2022. Paten terakhir menjabarkan “write automation circuit” dan menyebut “sebuah tugas tanpa kontrol cerdas dapat ditangani atau diproses melalui lapisan hardware”, sementara firmware menjaga pekerjaan seperti garbage collection.
Pengajuan 2014 melangkah lebih jauh, mengirim perintah I/O dasar ke jalur yang “sepenuhnya diimplementasikan dalam hardware”, dengan apa pun yang tidak dapat ditanganinya dikirim ke hulu. H-TPU sendiri dilaporkan dipakai dalam “Storage Next”, nama Nvidia untuk proyek AIN P bersama SK hynix. Storage Next menargetkan akses 512 byte atau lebih terbatas pada NAND, yang secara tradisional menyasar ukuran operasi lebih tinggi.
SK hynix juga berencana menerapkannya pada high-bandwidth flash (HBF), yang menurut outlet tersebut akan hadir tahun depan. HBF menumpuk die NAND untuk AI inference, menargetkan bandwidth setingkat high-bandwidth memory (HBM) tetapi dengan kapasitas jauh lebih besar, hingga 512GB per stack versus 64GB untuk HBM4. Untuk HBF, pembacaan AI inference jauh lebih banyak daripada penulisan, sekitar 300.000 banding 1, dengan compiler dan runtime AI meneruskan dataflow yang telah dianalisis sebelumnya ke SoC HBF. Manajemen buffer dan prefetching yang tepat berdasarkan dataflow itu dimaksudkan menyembunyikan latensi NAND yang lambat di balik komputasi.
Ukuran menjadi penting pada stack HBF, sehingga desain Arm multi-core tradisional kemungkinan kurang praktis. H-TPU belum terbukti pada produk controller SSD enterprise sungguhan, dan belum ada tanggal yang diberikan. Perpindahan dari core CPU general-purpose ke core dan sirkuit khusus satu tugas cocok dengan jenis beban kerja yang ditangani SSD, dan tuntutan pada penyimpanan hanya meningkat seiring server AI menjadi terbatas memori. Pernyataan dan paten SK hynix mendukung evolusi menuju H-TPU dan selanjutnya ke HWA, dengan H-TPU sendiri mengarah ke NAND tradisional dan HBF tahun depan.
Produsen controller SSD harus bersedia beradaptasi, karena scaling sederhana tidak optimal bahkan pada level PCIe saat ini, apalagi kecepatan yang dijanjikan untuk PCIe 7.0 dan 8.0, yang terakhir menuju ratifikasi final pada 2028.
Sebagai konteks industri, SK hynix juga tengah menjajaki langkah produksi chip memori di pabrik Intel Ohio, sebagaimana diberitakan dalam Produksi Chip Memori. Selain itu, tekanan pada pasokan memori turut menjadi sorotan, dengan situasi yang dibahas dalam Krisis RAM 2027. Di sisi roadmap memori, SK hynix juga dilaporkan menunda hybrid bonding ke HBM5, seperti diulas dalam HBM4E Masih MR-MUF.


Komentar
Belum ada komentar.