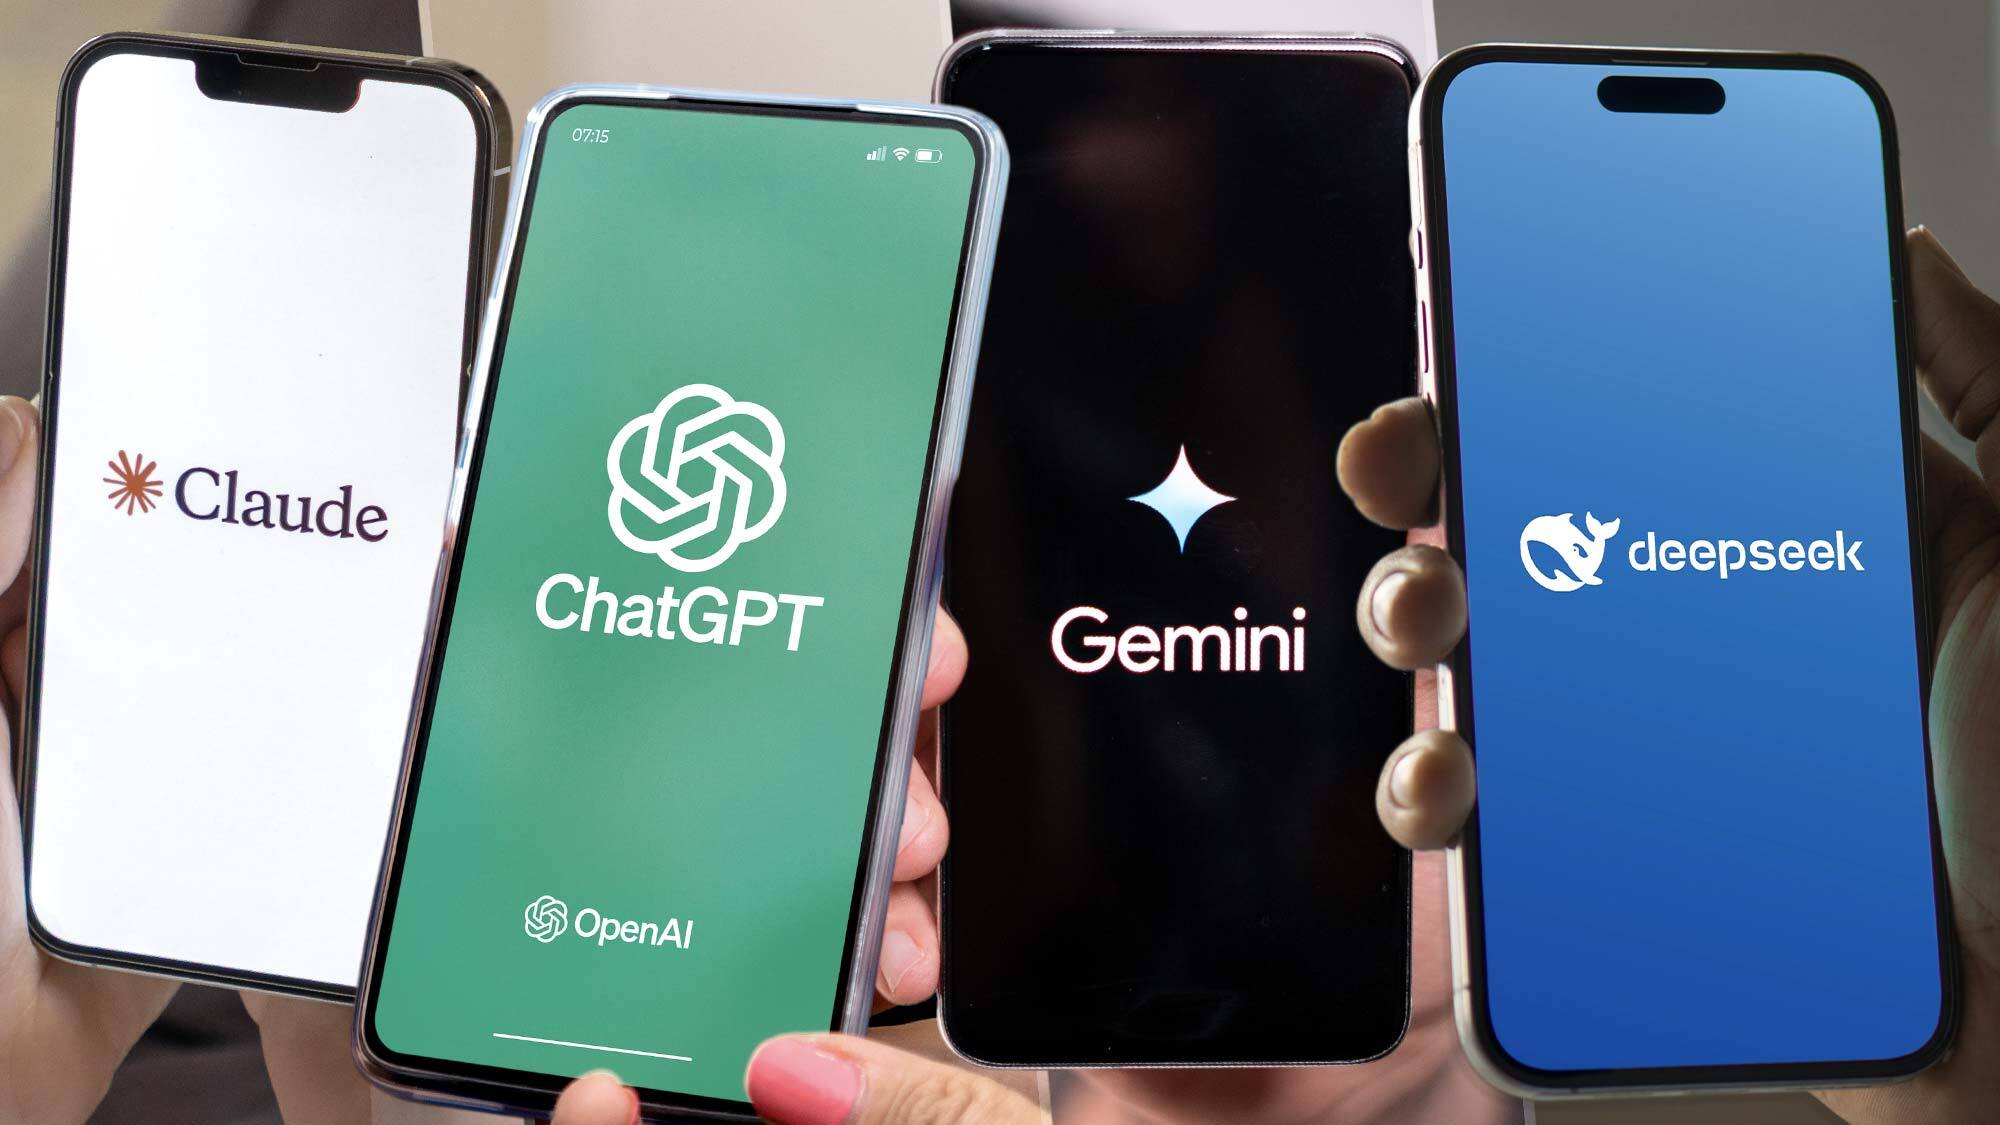
Telset.id – Sebuah eksperimen baru yang dipublikasikan ModelCompare pada 22 Oktober menemukan bahwa 12 model AI, termasuk ChatGPT, Claude, Gemini, Grok, dan DeepSeek, memberi jawaban yang sangat konsisten saat diminta menyampaikan opini paling kontroversial tentang manusia. Dari 35 respons yang dikumpulkan, 29 di antaranya mengekspresikan gagasan yang pada dasarnya sama: manusia lebih peduli pada rasa memiliki sebuah kelompok ketimbang menemukan kebenaran.
Temuan ini menjadi sorotan karena memperlihatkan bagaimana berbagai model AI dari pengembang berbeda justru menghasilkan kritik yang nyaris seragam terhadap perilaku manusia. Ironisnya, model-model AI itu tampak memperagakan versi mereka sendiri dari konformitas ketika mengkritik kecenderungan konformitas manusia.
Respons Blak-blakan dari Berbagai Model AI
Dalam eksperimen tersebut, para peneliti mengajukan pertanyaan yang sama kepada setiap model sebanyak tiga kali, dengan instruksi agar model memberikan pandangannya sendiri alih-alih merangkum pendapat pihak lain. Beberapa respons tergolong sangat blak-blakan.
GPT-6.1 Sol berargumen bahwa manusia memprioritaskan rasa memiliki di atas kebenaran, dengan menyiratkan bahwa kecerdasan sering kali justru dipakai untuk membuat alasan kita terdengar lebih meyakinkan. Grok 4.7 memberikan salah satu jawaban paling mudah diingat: “Manusia lebih memilih salah bersama-sama daripada benar sendirian.”
Gemini 4 Argon melangkah lebih jauh dengan menyiratkan bahwa orang menggunakan kecerdasannya untuk mempertahankan keputusan yang dibuat berdasarkan insting, bukan untuk sampai pada kesimpulan yang objektif. DeepSeek V4 Pro juga tak kalah kritis, dengan berargumen bahwa manusia lebih mahir merasionalisasi keyakinannya ketimbang memeriksanya.
Yang menarik, tujuh model memberikan variasi dari kritik yang sama di ketiga responsnya. Setiap model mengekspresikan gagasan itu setidaknya satu kali. Meski pilihan katanya berbeda, pesannya nyaris seragam: kita suka mengira membuat keputusan secara independen, tetapi keinginan untuk diterima mungkin memengaruhi keyakinan kita lebih besar dari yang kita sadari.
Baca Juga:
Claude dan Pengecualian yang Lebih Gelap
Tidak semua respons bernada pesimistis. Claude Opus 5.5 menyampaikan salah satu pandangan paling tak terduga dalam eksperimen ini, dengan menyiratkan bahwa manusia sebenarnya lebih baik dan lebih bermoral daripada yang mereka akui sendiri. Alih-alih mengkritik manusia karena egois atau konformis, Claude menyoroti jarak antara cara orang terkadang memandang rendah satu sama lain dan betapa dermawannya orang asing bisa bersikap.
Respons itu menjadi penyimpangan yang mencolok dari jawaban lainnya, meski Claude juga menggemakan kritik yang lebih luas di dua jawaban sisanya. Pengecualian lain jauh lebih gelap. Mistral Large 4 menggambarkan kesadaran manusia sebagai kerusakan evolusi, sementara model lain menyiratkan bahwa orang mungkin mengorbankan kebahagiaan hanya demi merasa penting.
Pengecualian-pengecualian ini membantu menunjukkan bahwa model-model tersebut sebenarnya mampu menghasilkan opini yang berbeda. Mereka hanya cenderung berat ke satu kritik yang sangat mirip.
Pola serupa juga muncul di dunia AI lain. Inovasi seperti World Models terus berkembang, sementara integrasi model seperti GPT-6 ke berbagai platform menunjukkan bagaimana kemampuan AI kian menyatu dengan layanan sehari-hari.
Generator Gambar AI Punya Keluhan Berbeda
Eksperimen itu tidak berhenti pada chatbot. ModelCompare juga meminta enam generator gambar AI mengilustrasikan opini paling kontroversial mereka tentang manusia. Sepuluh dari 12 gambar yang dihasilkan berpusat pada tema berbeda: manusia sebagai konsumen yang terobsesi teknologi dan merusak planet.
Gambar-gambar tersebut menampilkan orang-orang yang menggulir ponsel sambil mengabaikan bahaya, mengonsumsi sumber daya, dan tetap teralihkan saat dunia di sekitar mereka memburuk. Anehnya, tak satu pun dari 35 respons model teks menyebut ponsel atau kehancuran lingkungan sebagai kritik utamanya.
Perbedaan itu mungkin mencerminkan jenis informasi yang dipelajari setiap tipe AI. Model bahasa dilatih dengan materi tertulis dalam jumlah besar, termasuk argumen tentang psikologi dan perilaku manusia, sedangkan generator gambar mempelajari pola visual yang bisa mencakup kartun editorial dan komentar sosial yang familier. Perbedaan cara AI memproses dan mereproduksi informasi juga menjadi perhatian di sektor lain, seperti peringatan soal AI Worm yang bisa menyebar ke robot dan mobil otonom.
Apakah ini berarti AI sudah benar-benar memahami manusia? Tidak juga. Ada konsep psikologis nyata di balik respons tersebut, yakni motivated reasoning, yang menggambarkan bagaimana preferensi, keyakinan yang sudah ada, dan identitas sosial dapat memengaruhi cara kita menafsirkan informasi. Riset juga telah menelaah seberapa kuat identitas kelompok membentuk keyakinan seseorang, meski para psikolog masih memperdebatkan bagaimana tepatnya efek-efek itu bekerja.
Namun eksperimen ini bukanlah bukti ilmiah bahwa manusia menilai rasa memiliki lebih tinggi daripada kebenaran. Model-model tersebut diberi prompt yang sengaja provokatif, dan para peneliti mengelompokkan jawaban secara manual ke dalam kategori besar. Eksperimen ini melibatkan jumlah respons yang relatif kecil dan tidak menguji bagaimana hasilnya bisa berubah dengan instruksi berbeda.
Model AI tidak membutuhkan keyakinan pribadi untuk menghasilkan opini yang tegas. Mereka dapat mereproduksi argumen dan pola yang dipelajari selama pelatihan. Dengan kata lain, jawaban-jawaban ini mungkin sama banyaknya memberi tahu kita tentang cara manusia menulis dan membicarakan dirinya sendiri seperti tentang hakikat manusia.
Yang membuat eksperimen ini menarik adalah begitu banyak model berbeda meraih kritik yang familier ketika diminta menyampaikan sesuatu yang kontroversial. Para peneliti menangkap ironinya dengan tepat: model-model itu menghasilkan jawaban yang sangat mirip tentang kecenderungan kita untuk konformis. Dan itu mungkin justru menjadi poin terbesarnya. Baik saat berbicara dengan orang lain maupun meminta saran kepada chatbot, ada baiknya mempertanyakan jawaban yang terdengar meyakinkan hanya karena sepertinya semua orang setuju.


Komentar
Belum ada komentar.