Telset.id – Pusat data yang menjalankan beban kerja kecerdasan buatan (AI) berpotensi menekan konsumsi listrik hingga 30 persen hanya dengan mengoptimalkan sisi perangkat lunak. Temuan ini menjadi relevan ketika International Energy Agency (IEA) memperkirakan sekitar 945TWh listrik akan digunakan untuk memenuhi permintaan AI pada 2030, setara dengan konsumsi listrik Jepang saat ini.
Selama ini, respons industri terhadap krisis energi lebih banyak diarahkan pada sisi fisik: membangun GPU yang lebih efisien dan mengamankan pasokan daya dari jaringan listrik yang sudah ketat. Namun, fokus pada perangkat keras itu dinilai tidak cukup. Rata-rata power usage effectiveness (PUE) nyaris tidak berubah selama enam tahun berturut-turut menurut survei Uptime Institute 2025. PUE memang bisa menunjukkan apakah sistem pendingin dan daya boros, tetapi tidak menghitung apakah perangkat lunak yang berjalan di server benar-benar melakukan pekerjaan berguna.
Server menyumbang sekitar 60 persen kebutuhan listrik di pusat data modern. Sementara pendinginan berkisar dari sekitar 7 persen di fasilitas hyperscale yang efisien hingga lebih dari 30 persen di fasilitas enterprise yang kurang efisien. Karena itu, menggenjot efisiensi dari sisi perangkat lunak menjadi langkah yang masuk akal.
“Jawaban atas pertanyaan inti — ‘Bisakah perangkat lunak atau algoritma membantu secara berarti untuk daya dan energi?’ — adalah ya, 100 persen,” kata Jae-Won Chung, kandidat PhD di bidang ilmu komputer dan teknik di University of Michigan sekaligus peneliti di inisiatif ML.Energy, dalam wawancara dengan Tom’s Hardware Premium.
Chung menilai sistem komputasi seharusnya dipandang sebagai tumpukan dengan perangkat keras di lapisan bawah, ditopang perangkat lunak sistem, algoritma, dan aplikasi. Lapisan perangkat keras adalah bagian tersulit untuk diutak-atik karena chip mahal dan lambat diganti. Namun tiga lapisan lainnya lebih mudah diubah, dan setiap perbaikan efisiensi di sana bisa saling memperkuat.
Baca Juga:
Uji ML.Energy terhadap model Alibaba Qwen 3 235B A22B Thinking menunjukkan bahwa menjalankan inferensi dalam format FP8 — format presisi yang sedikit lebih rendah — mengonsumsi energi sepertiga lebih sedikit dibandingkan versi bfloat16 pada tugas pemecahan masalah. Optimizer pelatihan milik Chung, Perseus, mengidentifikasi bagian dari pekerjaan pelatihan model besar yang bebannya lebih ringan, lalu memperlambatnya agar selesai bersamaan dengan bagian yang lebih sibuk. Sistem itu memangkas energi pelatihan hingga 30 persen tanpa mengurangi throughput atau mengubah perangkat keras.
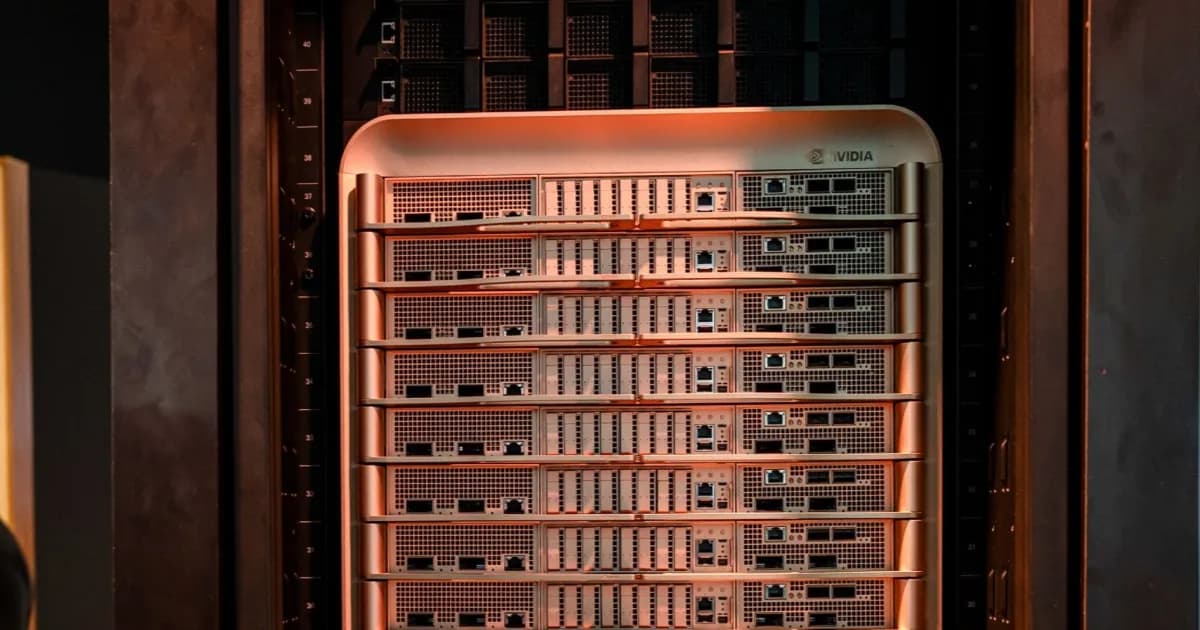
Langkah serupa juga dilakukan sebagian produsen GPU terbesar. Profil daya Nvidia Blackwell menyetel berbagai parameter, mulai dari frekuensi komputasi dan memori GPU, batas daya, status NVLink, hingga pengaturan cache agar sesuai dengan beban kerja. Nvidia meyakini pendekatan itu bisa menghemat hingga 15 persen energi sambil mempertahankan 97 persen atau lebih performa keseluruhan, sehingga fasilitas yang terbatas daya dapat menjalankan lebih banyak GPU dan menaikkan throughput hingga 13 persen.
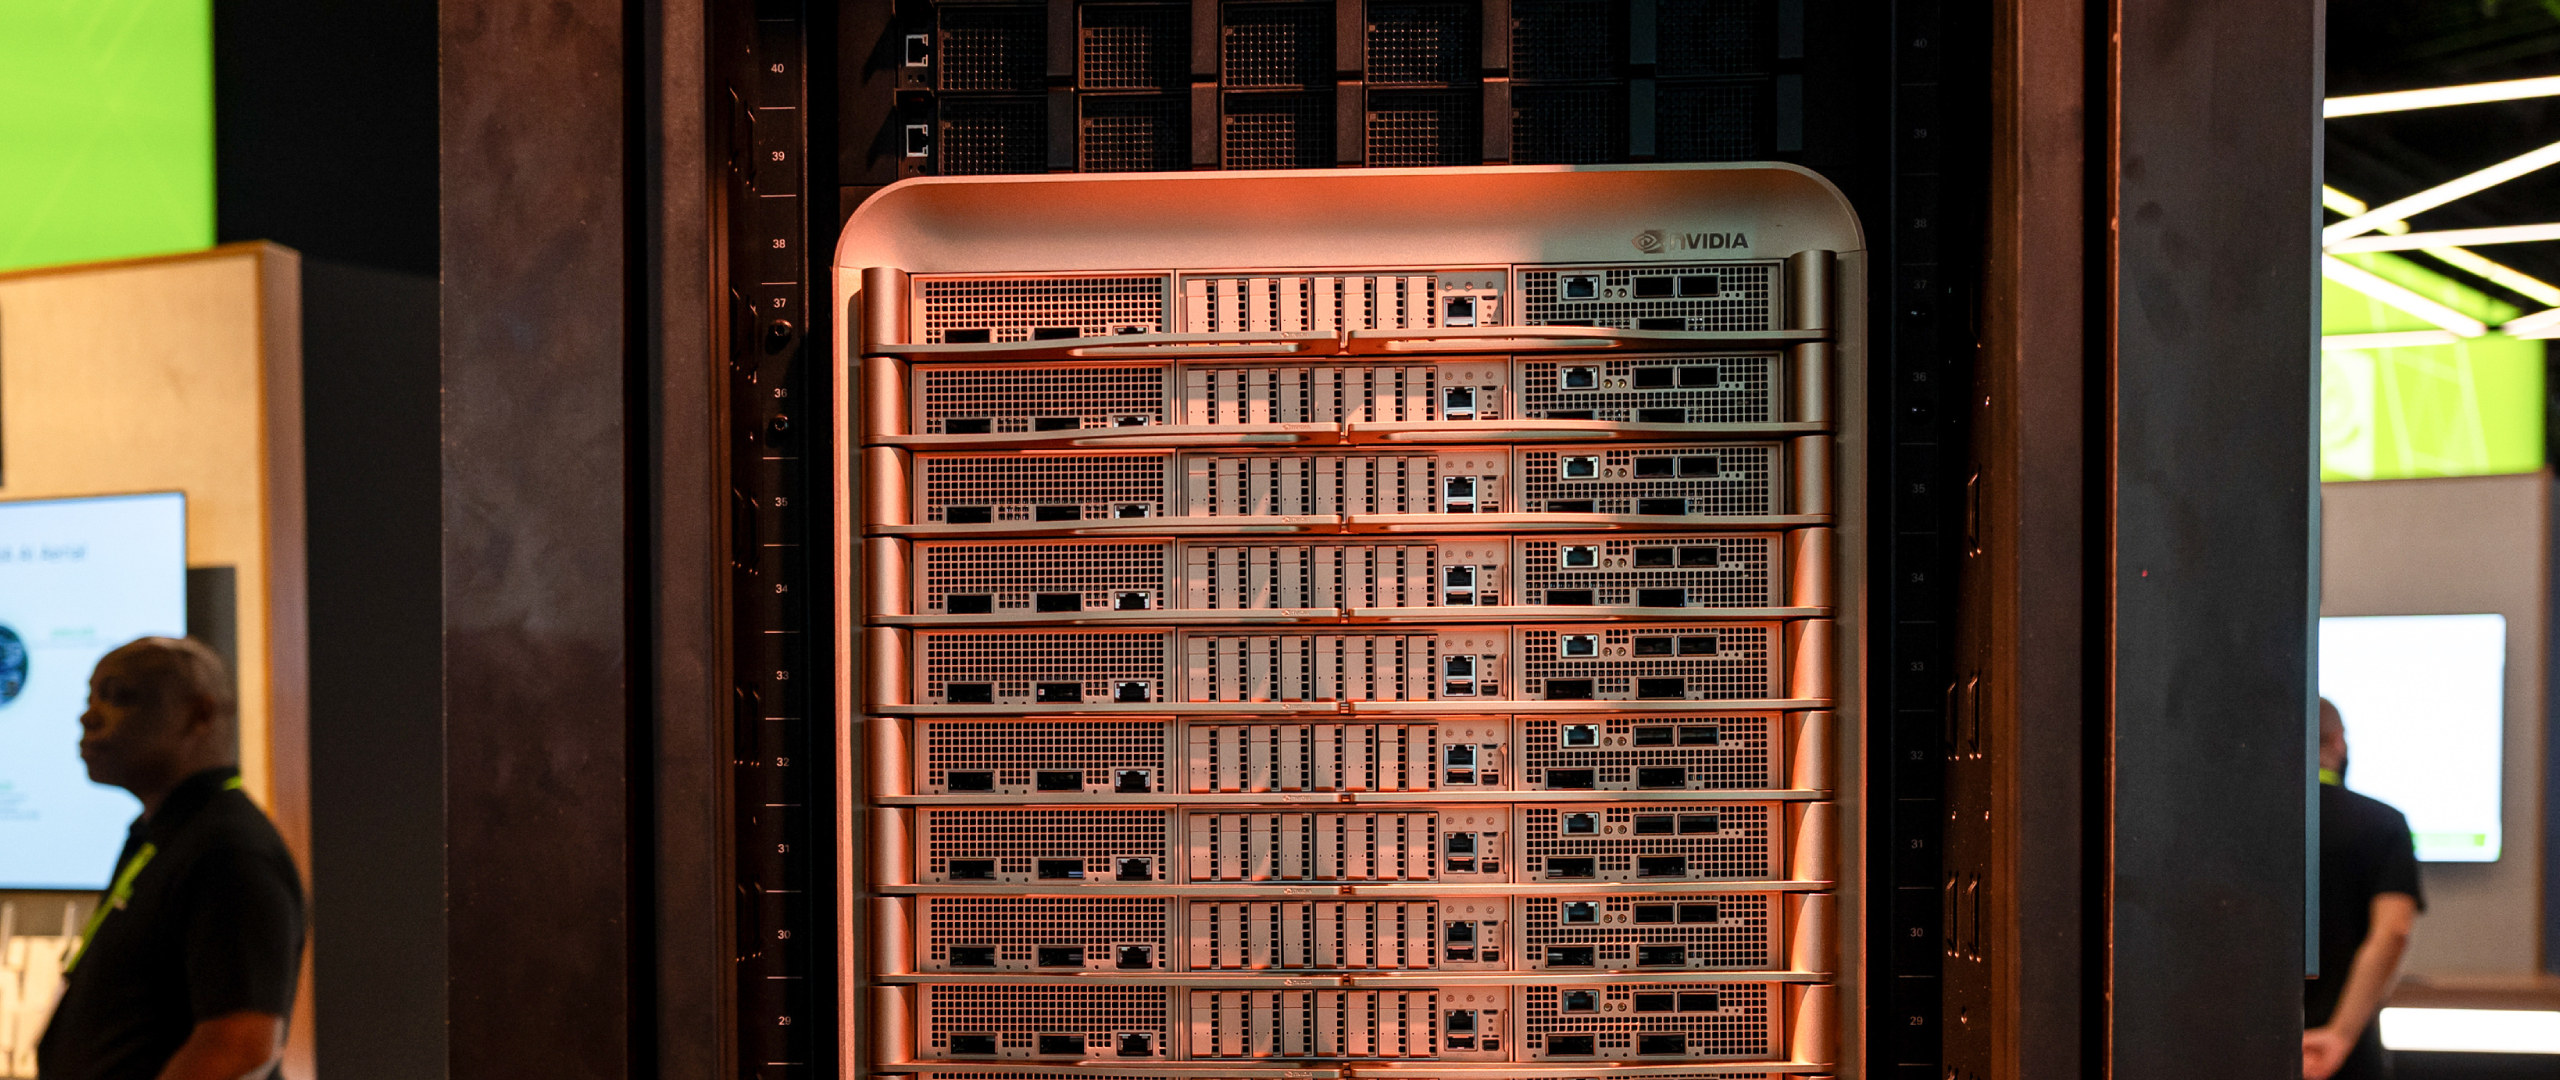
Chetan Visrolia, business development manager untuk infrastruktur pusat data di SHI, mengatakan dalam wawancara dengan Tom’s Hardware Premium bahwa pemborosan paling jelas yang ia temui sering kali adalah peralatan lama yang menopang kode usang. “Itu selalu menjadi buah yang paling mudah dipetik untuk penghematan cepat,” ujarnya. “Mudah ditemukan di pusat data mana pun, karena ia adalah rak paling berisik di lantai.”
Instans cloud juga bisa dibuat berukuran lebih cerdas, dan prompt AI yang digunakan berulang kali dapat disimpan dalam cache alih-alih dihitung ulang saat itu juga. Efisiensi juga bisa didapat dengan membiarkan model kecil menangani permintaan rutin sementara model besar disimpan untuk tugas yang lebih sulit. Pada saat yang sama, batching dan kompilator yang lebih baik dapat menaikkan utilisasi akselerator, sementara pemangkasan prompt dan pembatasan output bisa menekan jumlah token yang diproses.
Perangkat lunak juga dapat mengubah kapan dan di mana listrik ditarik. Sophie Hall, mahasiswa doktoral di Automatic Control Laboratory ETH Zurich yang mempelajari pergeseran beban kerja di seluruh armada pusat data global Google, berpendapat bahwa konsumsi listrik bukanlah masalah utamanya. “Ini lebih seperti: kapan mereka menggunakannya, di mana mereka menggunakannya, dan bagaimana interaksinya dengan jaringan listrik?” katanya.
Jika pekerjaan batch tidak sensitif waktu, pekerjaan itu bisa ditunda hingga permintaan lokal turun atau dialihkan ke wilayah dengan kapasitas cadangan dan listrik beremisi karbon lebih rendah. Riset Hall menggunakan perencanaan sehari sebelumnya dan penjadwalan waktu nyata untuk merespons sinyal jaringan listrik sambil menjaga jaminan performa.
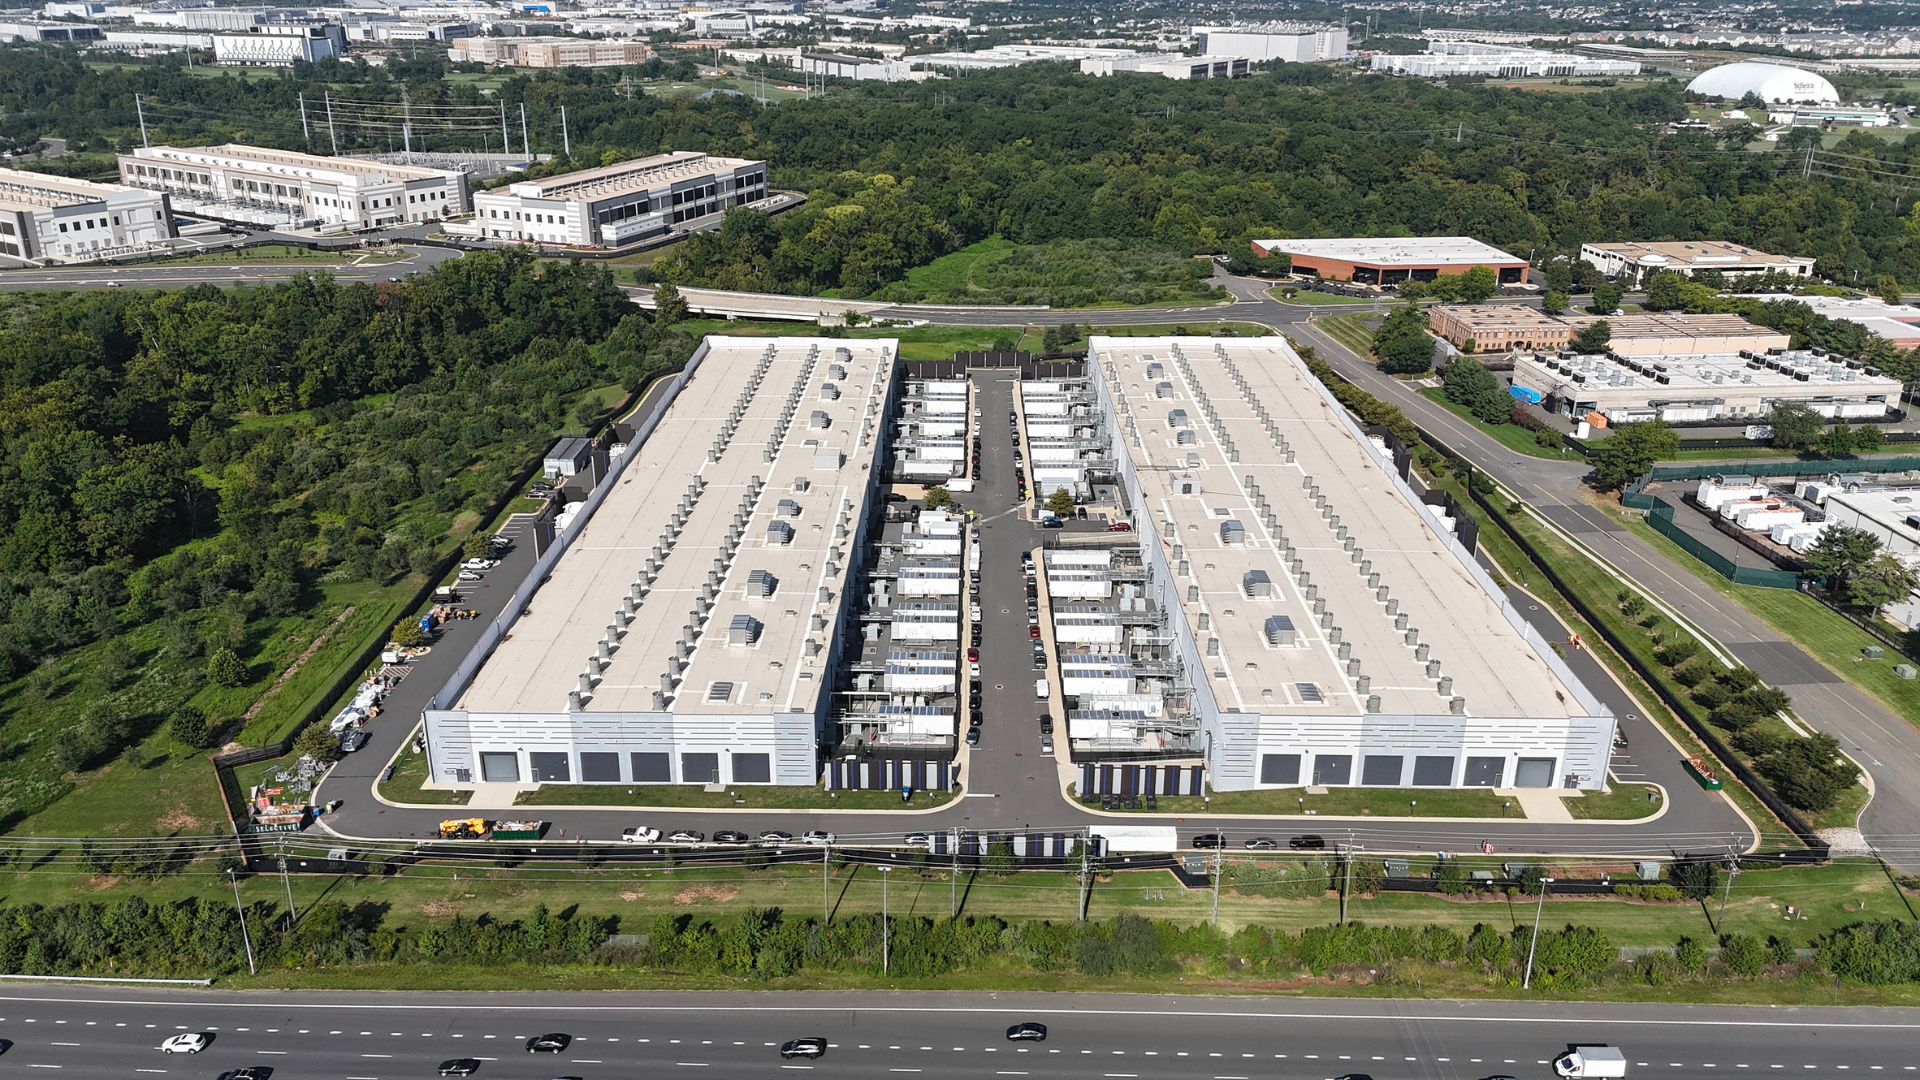
Menurut Hall, tindakan semacam itu tidak terlalu diperlukan ketika hyperscaler membangun kapasitas jauh melebihi kebutuhan dan jaringan listrik belum menjadi penghambat. Namun permintaan AI yang masif telah mengubah persamaan tersebut. Ada batasannya: aturan kedaulatan data masing-masing negara dapat mencegah beban kerja melintasi perbatasan, sementara memindahkan kumpulan data besar melalui jaringan menjadi hal yang mungkin dihindari penyedia inferensi jika terjadi masalah. “Data perlu benar-benar, secara fisik, bergerak secara geografis ke lokasi berbeda,” kata Hall. “Itu tidak mudah.”
Skala permintaan pusat data yang didorong AI berarti perangkat lunak bukanlah solusi tunggal atau pengganti chip yang lebih baik dan infrastruktur listrik baru. Namun perangkat lunak dapat berperan sebagai lapisan kendali yang memeras setiap tetes terakhir dari aset yang semakin mahal, sekaligus membantu menggeser permintaan ke tempat yang memiliki kapasitas lebih.
Paradoks Jevons juga berperan dan perlu dipertimbangkan ketika berpikir tentang membuat sistem berjalan lebih baik. Efisiensi tidak mengurangi penggunaan listrik sebuah fasilitas jika setiap watt yang dihemat justru terpakai untuk menghasilkan lebih banyak token. “Daya adalah penghambat inti di pusat data AI,” kata Chung. “Kami benar-benar ingin memanfaatkan setiap watt yang kami konsumsi sebaik mungkin.”
[INFO]
Informasi Tambahan
- Prediksi Konsumsi Listrik AI 2030: Sekitar 945TWh, setara konsumsi listrik Jepang saat ini (International Energy Agency).
- PUE Stagnan: Rata-rata power usage effectiveness tidak berubah signifikan selama enam tahun berturut-turut (Uptime Institute 2025).
- Porsi Listrik Server: Sekitar 60 persen kebutuhan listrik pusat data modern.
- Porsi Pendinginan: Sekitar 7 persen di hyperscale efisien hingga lebih dari 30 persen di fasilitas enterprise kurang efisien.
- Uji ML.Energy: Inferensi FP8 pada Alibaba Qwen 3 235B A22B Thinking hemat sepertiga energi dibanding bfloat16.
- Perseus Optimizer: Memangkas energi pelatihan hingga 30 persen tanpa mengurangi throughput.
- Profil Daya Nvidia Blackwell: Klaim hemat hingga 15 persen energi dengan performa 97 persen atau lebih, throughput naik hingga 13 persen.


Komentar
Belum ada komentar.