Telset.id – Huawei memperluas platform Ascend melalui sistem komputasi AI berskala besar yang dirancang menangani model dengan hingga 10 triliun parameter. Langkah ini menjadi cara Huawei mengompensasi keterbatasan perangkat keras akselerator Ascend individual saat bersaing dengan produk Nvidia, dengan mengandalkan jumlah prosesor yang lebih banyak dan komunikasi antar-chip yang lebih cepat.
Inti dari pendekatan tersebut adalah UnifiedBus, arsitektur interkoneksi Huawei untuk menghubungkan prosesor, memori, dan penyimpanan dengan overhead komunikasi yang lebih rendah. Arsitektur ini menghubungkan ribuan prosesor, memori, dan storage di dalam sistem AI berukuran besar.
Huawei menerapkan UnifiedBus pada Atlas 960E, varian Ascend 960 yang mampu menautkan hingga 4.096 NPU dan memberi mereka akses ke memori bersama di seluruh SuperPoD. Arsitektur ini juga membuat Atlas 960E menawarkan performa komputasi 8 EFLOPS FP8, sementara Huawei menyatakan sistem tersebut mendukung model berisi hingga 10 triliun parameter.
Roadmap Atlas 960 dan Akselerasi Ascend 960
Roadmap Atlas 960 SuperPoD Huawei menargetkan sistem yang memuat hingga 15.488 prosesor Ascend 960, naik dari konfigurasi sebelumnya yang berjumlah 8.192 prosesor. Huawei menyebut sistem ini dapat menghasilkan 30 EFLOPS komputasi FP8 dan 60 EFLOPS dengan FP4, disertai kapasitas memori 4.460 TB.
Bandwidth interkoneksinya disebut mencapai 34 PB/s, sementara Huawei memperkirakan performa pelatihan mencapai 15,9 juta token per detik. Huawei juga mempercepat pengembangan keluarga Ascend 960, dengan Ascend 960DT dijadwalkan pada Q1 2027 dan Ascend 960PR pada Q3 2027. Perusahaan menyatakan kedua versi akan hadir lebih cepat dari perkiraan sebelumnya, dan peningkatan performa telah melampaui roadmap awal.
Percepatan jadwal itu sejalan dengan langkah yang sebelumnya dilaporkan pada Peluncuran Ascend 960DT yang memang dijadwalkan lebih awal ke Q1 2027.
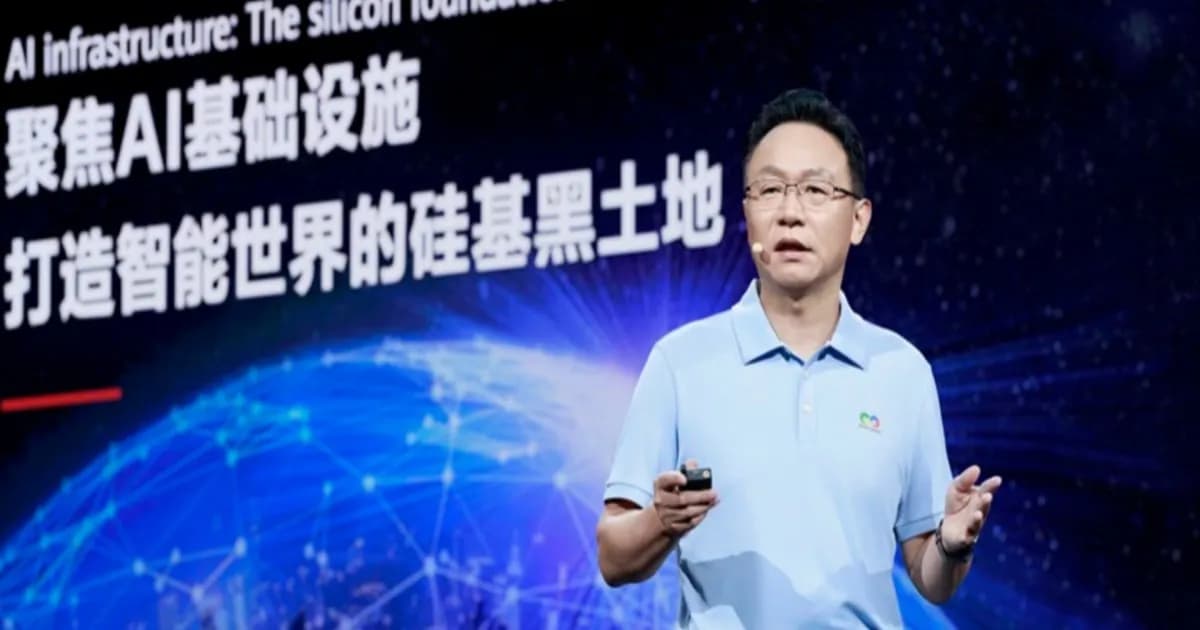
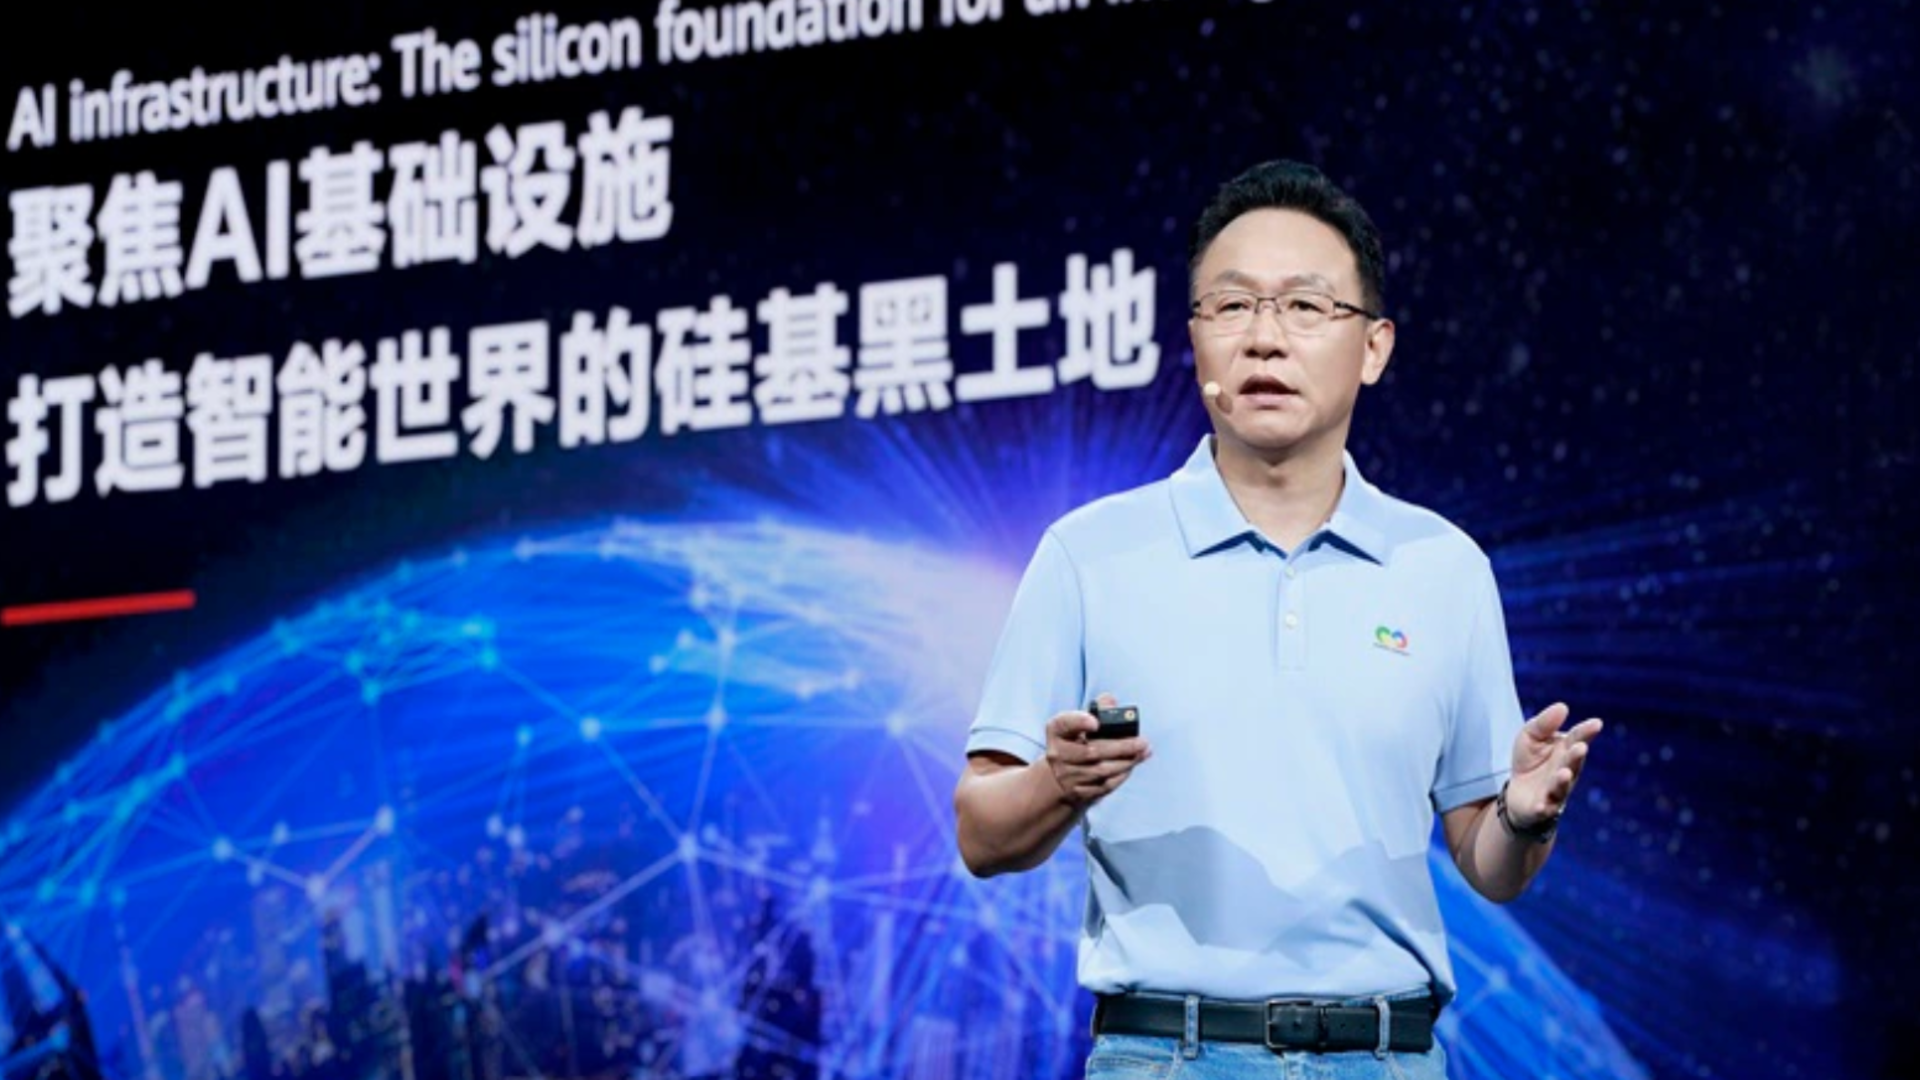
“Kami mengembangkan seri chip Ascend dengan siklus satu generasi per tahun,” kata David Wang, deputy chairman dan rotating chairman Huawei. “Pada 2028 dan 2029, kami akan meluncurkan chip Ascend 970 dan 980. Berkat Tau (τ) Scaling Law, spesifikasi komputasi mereka akan terus berlipat ganda, dan Anda juga bisa mengharapkan peningkatan yang besar.”
Baca Juga:
Hi-ONE dan NPO Tekan Konsumsi Daya Interkoneksi
Pada sisi interkoneksi, Huawei menggabungkan UnifiedBus dengan teknologi optik Hi-ONE untuk memperluas koneksi optik berkecepatan tinggi lebih dalam ke sistem komputasi. Pendekatan ini memakai near-packaged optics (NPO) yang menempatkan komponen optik lebih dekat ke prosesor guna meningkatkan kecepatan transmisi dan menekan konsumsi energi.
Huawei menyatakan desain tersebut membantu SuperPoD memindahkan data antar ribuan prosesor tanpa sepenuhnya bergantung pada koneksi optik konvensional di luar sistem komputasi. Atlas 960E dapat menggunakan sekitar 5.500 unit Hi-ONE sebagai pengganti sekitar 48.000 modul optik 800G konvensional.
Konfigurasi itu dapat menurunkan konsumsi daya lebih dari 550 kilowatt di seluruh sistem interkoneksi prosesor. Sistem Atlas 960E juga dapat terhubung ke SuperCluster yang memuat 512.000 NPU, dengan arsitektur yang pada akhirnya mendukung konfigurasi sejuta prosesor.
Sistem berukuran lebih besar menjadi penting karena Huawei tidak dapat sepenuhnya mengandalkan performa akselerator individual untuk mempersempit jarak dengan Nvidia. Strategi perusahaan menggabungkan lebih banyak prosesor dengan komunikasi yang lebih cepat, sehingga ribuan chip dapat beroperasi dalam lingkungan komputasi bersama.
UnifiedBus karena itu menjadi krusial sebab ribuan prosesor harus terus bertukar data selama beban kerja pelatihan dan inferensi AI yang berat. Pendekatan ini juga menjadi bagian dari strategi Huawei di lini chip AI-nya, termasuk kebijakan pemasaran yang dibahas dalam Pasar China Ascend 900.
Dengan roadmap yang mencakup Ascend 970 pada 2028 dan Ascend 980 pada 2029, Huawei menempatkan skala sistem, kapasitas memori, dan interkoneksi cepat sebagai fondasi pengembangan platform Ascend berikutnya.


Komentar
Belum ada komentar.